9월 17일, Affirm이 신규 고객 심사에 트랜스포머 모델을 쓰기 시작했다고 발표했다.
Affirm은 미국의 BNPL(선구매 후결제) 회사다. 결제 화면에서 1초도 안 되는 사이에 할부를 승인할지 정하는데, 그 판단을 지금까지 XGBoost가 해 왔다. 새 모델도 XGBoost를 버리지 않았다. 트랜스포머가 신용정보를 읽어 임베딩을 만들고, 그 임베딩을 기존 XGBoost에 피처로 넣는 구조다.
올해 비슷한 발표가 계속 나왔다. 4월에는 Revolut이 은행 이벤트 240억 건으로 학습한 기반 모델 PRAGMA 논문을 냈다. 5월에는 브라질의 누뱅크가 트랜스포머 신용 모델 nuFormer의 성과를 발표했다. 같은 달 소상공인 대출을 하는 Parafin은 XGBoost 앙상블을 트랜스포머 하나로 바꿨다고 썼다. 8월에는 앤트 계열의 Ant International이 시계열 모델 Falcon TST 2.0을 내놨다.
모두 트랜스포머를 썼다고 하지만, 무엇을 예측하는지와 트리 모델을 어떻게 다뤘는지는 회사마다 꽤 다르다.
1. 올해 나온 사례들
| 회사 | 공개 | 예측 대상 | 입력 | 트리 모델과의 관계 |
|---|---|---|---|---|
| Nubank (nuFormer) | 2025년 7월 논문, 2026년 8월 개정 | 신용 부도 등 | 카드·계좌 거래 시퀀스 | LightGBM 대신 미분 가능한 표 모델과 함께 학습 |
| Revolut (PRAGMA) | 2026년 4월 논문, 8월 개정 | 신용, 사기, 추천 등 여러 과제 | 앱·거래·투자 이벤트 시퀀스 | 비교 대상 모델의 종류 비공개 |
| Parafin (ParaFormer) | 2026년 5월 | 소상공인의 향후 12개월 매출 분포 | 일별 매출을 월 단위로 묶은 시계열 | XGBoost 앙상블을 대체 |
| Ant International (Falcon TST) | 2025년 11월 1.0, 2026년 8월 2.0 | 현금흐름, 환 노출 | 시계열 | 신용 모델이 아님 |
| Affirm | 2026년 9월 | 신규 고객의 연체 위험 | 신용정보의 계좌·조회 기록 | 임베딩을 XGBoost에 입력 |
Revolut은 사용자 2,600만 명의 25개월치 이벤트로 모델을 학습했다. 카드 결제, 앱 화면 이동, 주식 거래, 고객에게 보낸 커뮤니케이션 같은 기록이다. 이렇게 만든 모델 하나를 두고 신용평가, 사기 탐지, 상품 추천 같은 과제마다 가벼운 헤드를 얹거나 미세조정해서 쓴다.
누뱅크는 고객 1억 명 이상의 거래 1천억 건 이상으로, GPT처럼 다음 토큰을 맞히는 방식의 트랜스포머를 사전학습했다. 논문 기준으로 신용 부도 예측 AUC가 LightGBM보다 상대적으로 1.25% 높았다. 회사는 5월 보도자료에서 같은 조건의 고객군에서 위험이 70% 줄었다고 했는데, 무엇을 어떻게 잰 숫자인지는 밝히지 않았다.
Parafin은 Amazon, DoorDash 같은 플랫폼 안에서 셀러에게 돈을 빌려주는 회사다. 9월 말에는 Stripe에 인수된다고 발표했다. ParaFormer는 부도 예측 모델이 아니라, 셀러의 향후 12개월 매출이 어느 범위에 있을지 예측해서 대출 한도를 정하는 데 쓰는 모델이다.
Falcon TST는 중국 매체에서 鹰序(잉쉬) TST로 불린다. 만든 곳은 국내 알리페이가 아니라 앤트그룹 계열의 싱가포르 법인 Ant International이다. 회사 자체의 현금흐름과 환 노출을 예측하는 데 쓴다. 씨티, 바클레이즈, 스탠다드차타드, 도이치은행이 외환 상품이나 유동성 관리에 붙였다고 발표했다.
앤트그룹에는 신용에 더 가까운 사례가 따로 있다. 2025년 5월 말 arXiv에 올라온 BYB 논문이다. 알리페이 사용자 약 1천만 명의 180일치 앱 행동으로 4층짜리 트랜스포머 인코더를 사전학습했다. 사전학습 방식이 특이하다. 기존 방식처럼 사람이 골라 둔 행동 어휘의 분포를 맞히지 않고, 학생·교사 두 인코더를 두고 앞으로 일정 기간의 행동 전체를 요약한 임베딩을 맞히게 했다. 두 달 동안 실제 서비스에 적용한 결과, 연체 위험을 예측하는 두 과제에서 KS가 약 2.7%, 7.1% 올랐다고 적었다.
결제와 사기 탐지 쪽에서도 비슷한 발표가 있었다. Stripe는 수백억 건의 거래로 학습한 결제 기반 모델을 붙였다. 그 뒤 대형 가맹점을 노린 카드 테스팅 공격의 탐지율이 59%에서 97%로 올랐다고 밝혔다. 정교한 공격 일부에 한정한 숫자다. Featurespace를 인수한 Visa는 거래 데이터용 대형 모델(LTM)을 내놓았다. 개념 검증에서 운영 중인 GBT 모델보다 사기 금액을 5배 넘게 잡았다고 했다. 이 결과에는 예시용이라는 각주가 달려 있다.
2. 트리 모델이 보는 신용정보
신용정보는 원래 고객 한 명당 한 줄로 정리된 데이터가 아니다. 한 사람에게 계좌가 여러 개 있고, 계좌마다 개설일, 한도, 잔액이 있다. 여기에 매달 제때 갚았는지, 며칠 늦었는지가 한 칸씩 쌓인다. 계좌 수도 이력 길이도 사람마다 다르다.
트리 모델은 고객 한 명을 고정된 길이의 한 줄로 받아야 하므로, 사람이 집계 피처를 만든다. 최근 6개월 연체 계좌 수, 마지막 연체 후 지난 개월 수, 카드 한도 소진율 같은 것들이다. 이런 피처를 많게는 수백 개 만들고 그 위에 GBDT를 올리는 것이 지금 신용 모델의 일반적인 구조다.
이 방식은 실제로 잘 작동하고 연구로도 뒷받침된다. 2022년 NeurIPS에 실린 Grinsztajn 등의 연구는 데이터셋 45개로 실험했다. 결론은 1만 건 안팎의 중간 규모 정형 데이터에서 트리 기반 모델이 여전히 최고라는 것이었다. 2025년 TabArena 벤치마크도 부스팅 트리를 여전히 강한 후보로 봤다. 다만 시간을 넉넉히 주고 앙상블하면 딥러닝이 따라오고, 작은 데이터에서는 TabPFN 같은 기반 모델이 앞선다고 덧붙였다.
트리는 빠르고, 결측값에 둔감하고, 변수별로 단조 제약을 걸 수 있다. 거절 사유를 설명하기도 편하다. 대신 집계하는 과정에서 일부 정보가 사라진다.
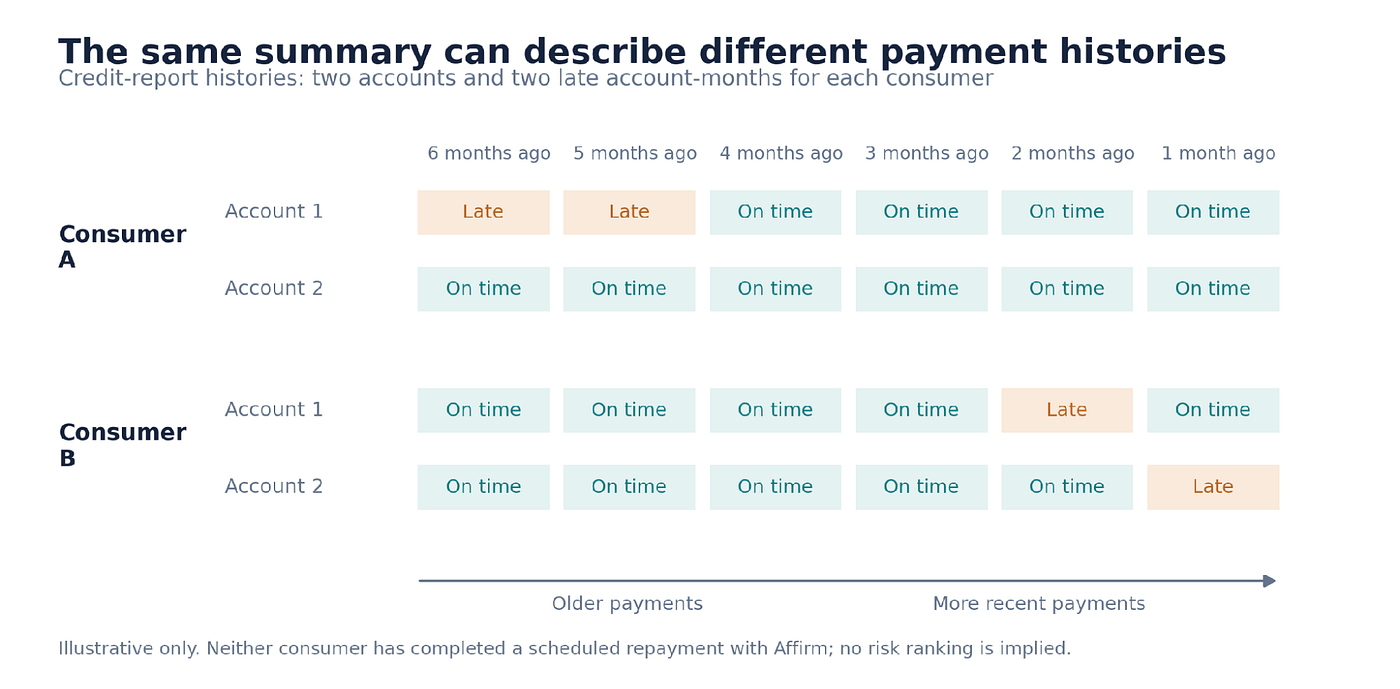
두 고객 모두 계좌 2개에 연체한 달이 2번이다. 요약값은 같지만 이력은 다르다. (출처: Affirm Tech Blog)
Affirm이 든 예시다. A는 한 계좌에서 5~6개월 전에 두 번 늦었고 그 뒤로는 제때 갚았다. B는 두 계좌에서 최근 두 달 사이에 한 번씩 늦었다. “최근 6개월 연체 횟수”로 집계하면 둘 다 2다.
누가 더 위험한지는 이 그림만으로 말할 수 없고, Affirm도 순위를 매기려는 그림이 아니라고 적었다. 요점은 요약값이 같아도 이력이 다를 수 있다는 것이다.
물론 “최근 3개월 연체 횟수”를 하나 더 만들면 둘은 갈린다. 그런데 계좌 수와 개월 수와 연체 단계의 조합을 다 피처로 만들 수는 없고, 어떤 조합이 쓸모 있는지는 결국 사람이 고른다.
3. 계좌 하나를 토큰 하나로
이번 사례들은 이 집계 단계를 모델에 맡긴다. Affirm은 신용정보의 계좌 하나(tradeline)를 토큰 하나로 만들었다. 단어 대신 레코드 하나가 토큰이 되는 셈이다. 토큰 안에는 계좌의 숫자 속성과 범주 속성이 들어간다. 매달의 상환 상태는 상태와 순서를 함께 인코딩해서 그 계좌 토큰에 넣는다. 신용 조회 기록도 따로 토큰이 된다.
이렇게 만든 토큰들 사이에 attention이 걸린다. 그러면 어떤 계좌의 최근 연체가 다른 계좌의 높은 한도 소진과 함께 나타나는지 같은 관계를 모델이 직접 학습할 수 있다. 사람이 교차 피처를 미리 만들어 둘 필요가 그만큼 줄어든다.
Revolut은 이벤트 하나를 다시 필드 단위로 쪼개서 토큰을 만들었다.
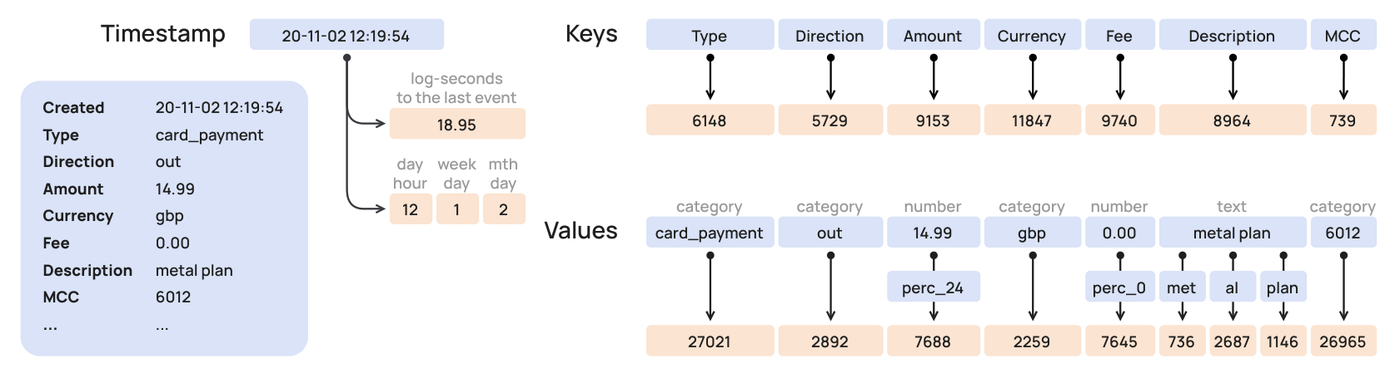
카드 결제 한 건을 키, 값, 시간으로 나눈다. 금액은 분위수 구간 토큰으로, 설명 문구는 BPE 토큰으로 바뀐다. (출처: Ostroukhov et al., PRAGMA, arXiv:2604.08649, CC BY 4.0)
이벤트의 필드마다 키 토큰과 값 토큰을 만든다. 금액 같은 숫자는 학습 데이터에서 구한 분위수 구간으로 바꾸고, 0은 따로 구간을 둔다. 업종 코드(MCC) 같은 범주는 토큰 하나로 두고, 가맹점 설명 같은 자유 텍스트는 BPE로 쪼갠다. 시간은 직전 이벤트와의 간격에 로그를 씌운 값과 시각·요일·날짜 같은 달력 정보로 넣는다.
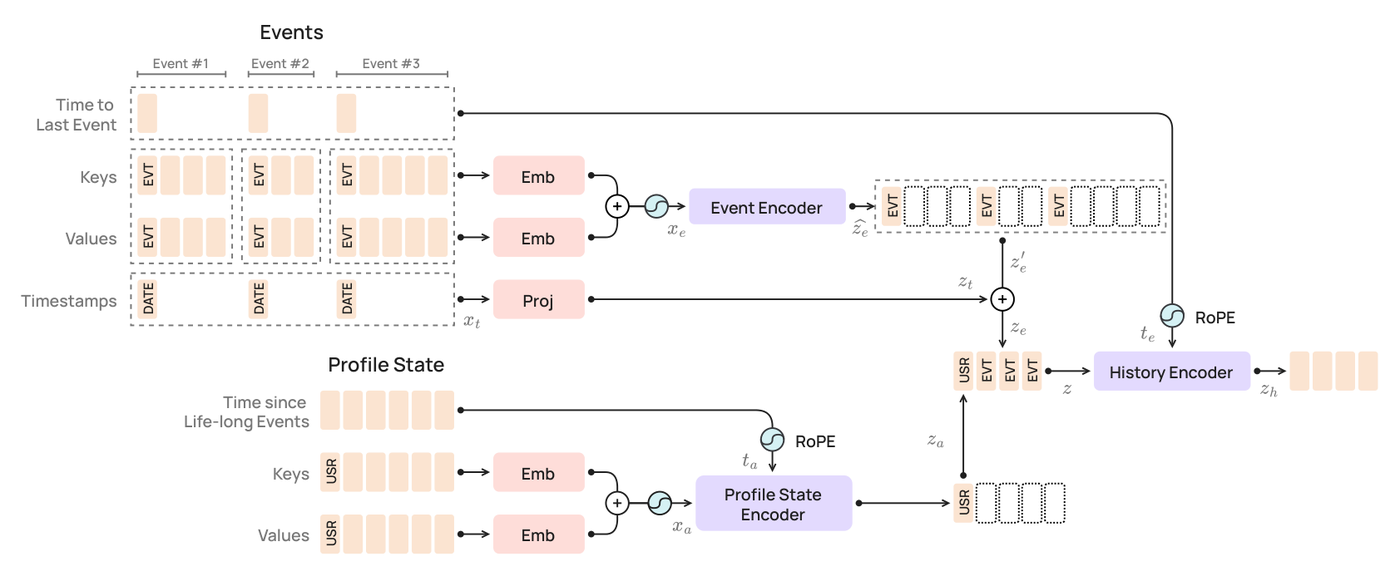
이벤트마다 Event Encoder가 [EVT] 임베딩을 만들고, History Encoder가 이벤트 순서 전체를 읽는다. 프로필 정보는 Profile State Encoder로 따로 들어간다. (출처: PRAGMA, arXiv:2604.08649, CC BY 4.0)
모델은 인코더 세 개로 이뤄져 있다. 이벤트 하나하나를 요약하는 인코더가 있고, 그 요약들의 순서를 읽는 인코더와 잔액 구간이나 요금제 같은 프로필을 읽는 인코더가 따로 있다. 크기는 1천만, 1억, 10억 파라미터 세 가지로 만들었다.
사전학습 방식은 회사마다 달랐다. Revolut은 BERT처럼 입력 일부를 가리고 맞히게 했다. 토큰 15%, 이벤트 통째로 10%, 특정 키의 값 전체 10%를 가린다. 그다음 과제별로 가벼운 분류 헤드를 얹거나 미세조정한다. 누뱅크는 GPT처럼 다음 토큰을 맞히게 했다. 거래 한 건은 금액 부호, 금액 구간, 월·일·요일 토큰과 설명 문구의 BPE 토큰으로 바뀐다.
Revolut 논문에서는 사전학습이 효과가 있었다. 1억 파라미터 모델을 기준으로, 같은 구조를 사전학습 없이 처음부터 학습한 것보다 신용평가 PR-AUC가 13.0%, ROC-AUC가 1.6% 높았다.
Affirm도 가려서 맞히는 자기지도 사전학습을 해 봤지만, 상환 결과를 라벨로 쓰는 지도학습이 더 좋았다. 첫 상환이 4일 이상 늦는지(FPDQ4) 같은 짧은 결과와, 상환 기간 안에 60일 이상 연체하는지(DQ60) 같은 긴 결과를 여러 헤드로 같이 맞히게 했다. 자기지도 기준 모델과 비교한 FPDQ60 AUC 개선 폭은 자기지도를 다듬은 버전이 25bp, 지도학습 멀티헤드를 다듬은 버전이 187bp였다. 다만 자기지도 쪽에는 연구 시간을 덜 썼다고 각주를 달았다.
이 차이는 데이터 규모와 과제 구성에서 온다고 본다. Revolut과 누뱅크는 학습 데이터가 각각 240억 건, 1천억 건이 넘고 모델을 쓸 과제도 여럿이다. Affirm은 심사라는 과제 하나에 라벨이 충분하다. 여러 과제가 함께 쓸 표현을 미리 만들어 둘 이유는 앞의 두 회사에 더 많다.
4. 트리 모델과 같이 쓰는 방식
Affirm은 트랜스포머를 XGBoost 앞단에 두고, 신용정보를 임베딩으로 바꾸는 역할만 맡겼다.
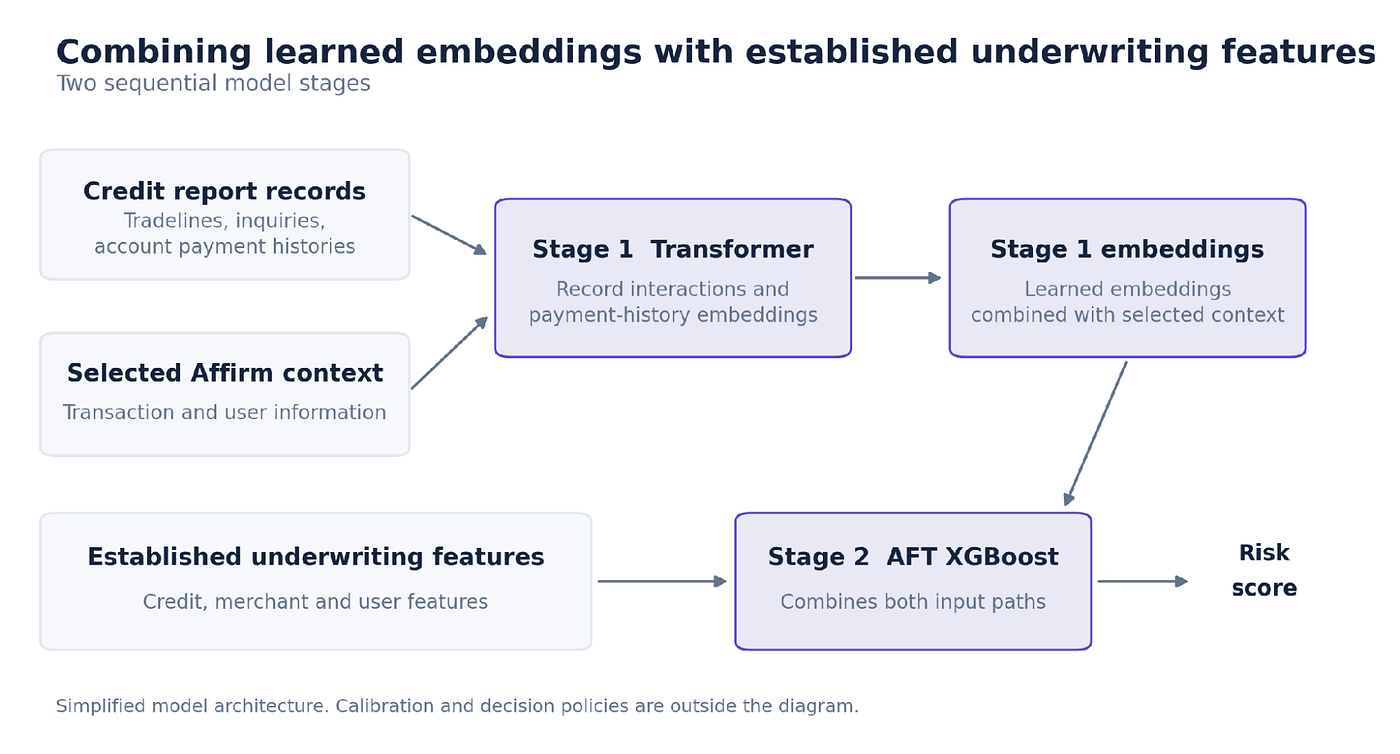
1단계 트랜스포머가 신용정보로 임베딩을 만들고, 2단계 AFT XGBoost가 그 임베딩과 기존 심사 피처를 합쳐 위험 점수를 낸다. (출처: Affirm Tech Blog)
임베딩은 예측 헤드 바로 앞 층에서 뽑는다. 2단계 XGBoost는 생존 분석 형태의 AFT 목적함수로 학습한다. 기존에 쓰던 신용, 가맹점, 사용자 피처도 그대로 들어간다. Affirm은 트랜스포머만 단독으로 쓰는 방법도 시험했다. 그런데 운영에 올릴 만큼 좋은 최고 XGBoost를 한 번도 넘지 못했다고 밝혔다.
하이브리드 성능은 운영 모델과 비교했고, 같은 기간에 연구하던 다음 버전 XGBoost와도 나란히 놓았다. 평가는 한 달치 대출을 떼어 둔 시간 홀드아웃으로 했다.
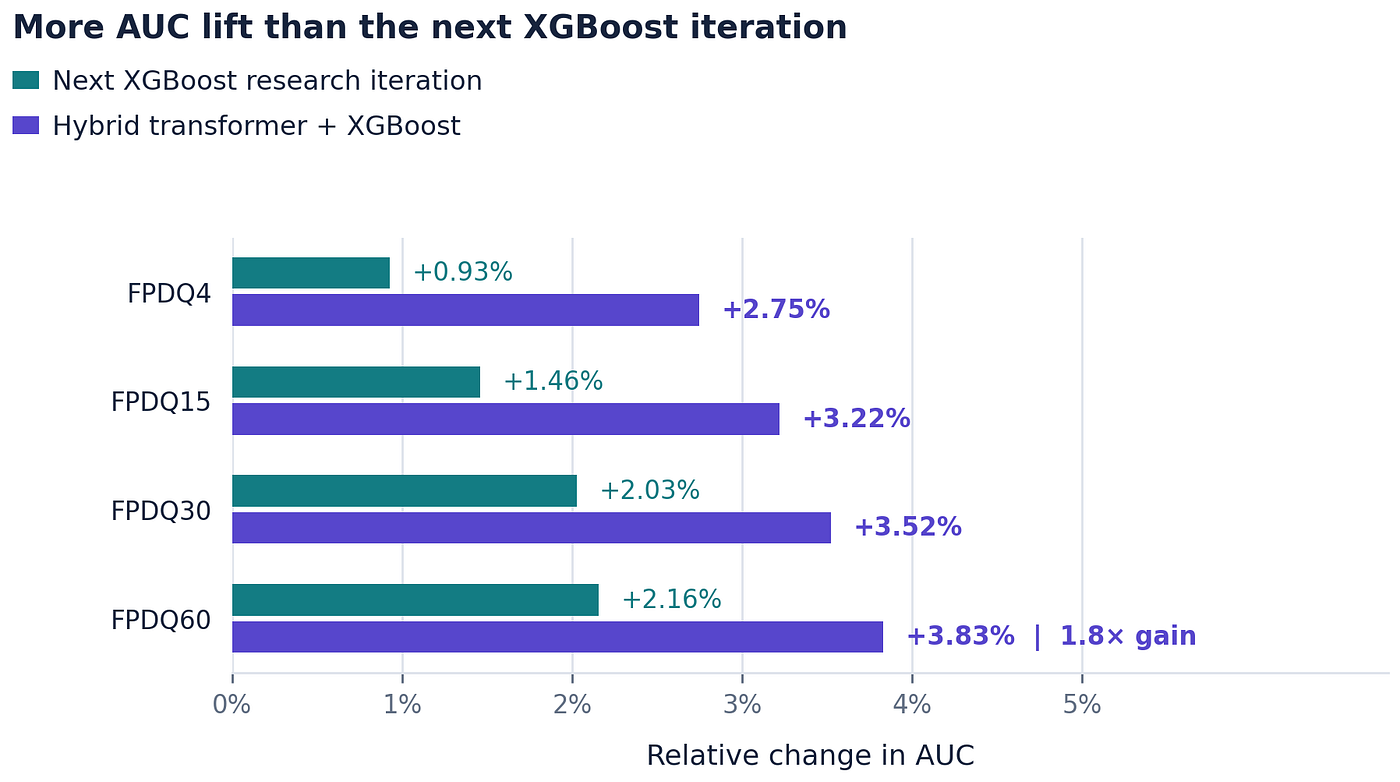
운영 모델 대비 AUC 상대 변화. FPDQ60은 첫 상환이 60일 이상 늦어지는지를 뜻한다. (출처: Affirm Tech Blog)
FPDQ60 기준으로 다음 버전 XGBoost는 +2.16%, 하이브리드는 +3.83%였다. Affirm이 말하는 “1.8배”는 이 두 개선 폭의 비율이다. 신용정보는 있지만 FICO 점수가 안 나오는 얇은 이력(thin file) 고객에서는 +4.64% 대 +9.84%로 차이가 2.1배였다.
실제 서비스에서는 기존 모델이 거절했을 신청 일부를 이 모델로 다시 보고 승인하는 실험부터 했다. 전환율이 1.2%p, 상대적으로 3.4% 올랐다. 그렇게 추가로 나간 대출은 이전 XGBoost로 같은 규모만큼 승인을 늘렸을 때보다 성과가 좋았다고 했다. 지금은 신규 고객의 승인과 거절 전체를 이 모델로 정하는 실험을 하고 있고, 다음 버전은 기존 고객까지 넓힌다.
Revolut은 반대로 기반 모델 하나를 두고, 과제마다 그 위에 필요한 부분만 학습한다. 간단한 방법은 모델을 고정한 채 임베딩에 로지스틱 회귀만 학습하는 선형 프로브로, 보통 몇 분이면 끝난다. 더 많이 학습하는 방법은 LoRA로 파라미터의 2~4%만 미세조정하는 것이다. 논문은 차원이 낮은 임베딩 위에서는 GBDT도 잘 작동한다고 적었다. 기본으로 쓰지 않은 이유는 과제마다 튜닝이 필요하고 학습이 오래 걸리기 때문이었다.
누뱅크는 한 걸음 더 갔다. 트리 모델은 기울기를 넘겨주지 못해서 트랜스포머와 한꺼번에 학습할 수 없다. 그래서 LightGBM 자리에 미분 가능한 표 모델(DCNv2)을 놓고 트랜스포머와 끝까지 같이 학습했다. 논문은 이걸 joint fusion이라고 부른다.
논문의 비교 결과를 보면, 표 모델만 바꿨을 때는 LightGBM과 거의 같았다(+0.08%). 트랜스포머 임베딩을 LightGBM에 넣기만 해도 +0.97%가 나왔고, 둘을 같이 학습하면 +1.25%였다. 개선의 대부분은 Affirm처럼 임베딩을 더하는 단계에서 이미 나온다.
매출 예측에서는 Parafin이 트리 모델을 완전히 걷어냈다.
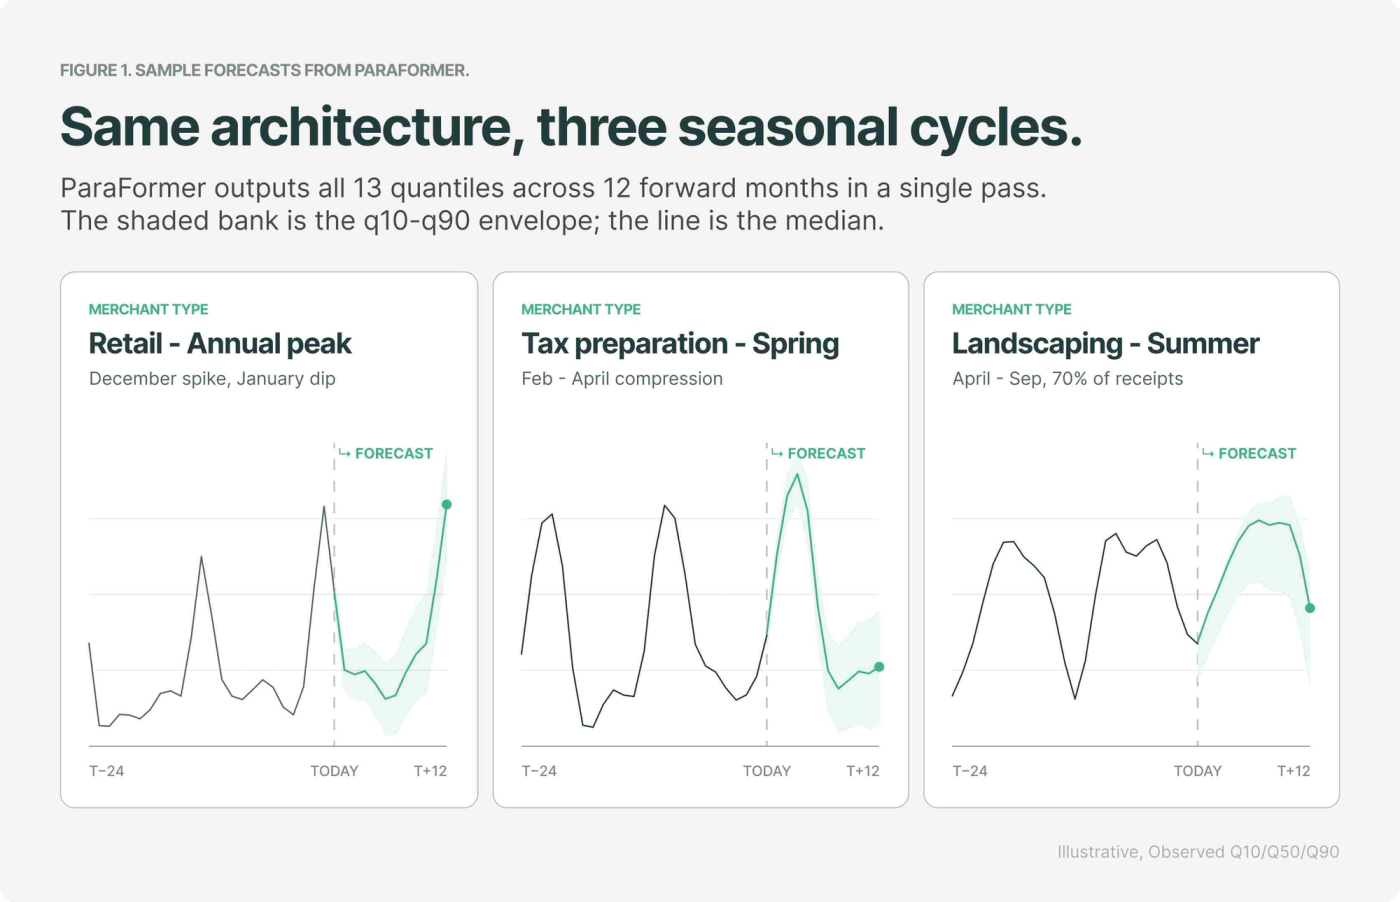
소매, 세무 대행, 조경 업체의 과거 24개월 매출과 향후 12개월 예측. 음영은 10~90% 분위수 구간이다. (출처: Parafin)
예전에는 분위수 7개와 예측 기간 4개를 조합한 XGBoost 28개가 따로 돌았고, 공변량은 130개쯤이었다. ParaFormer는 이걸 Temporal Fusion Transformer 하나로 바꿨다. 일별 매출을 월 단위로 묶은 지난 32개월치를 보고, 앞으로 12개월에 대해 10%부터 90%까지 5%p 간격의 분위수 17개를 한 번에 낸다.
앞서 말했듯 이 모델은 한도를 정하기 위한 매출 예측 모델이다. Parafin은 이 모델을 연체나 손실 데이터로 학습하지 않았고, 손실을 예측하는 모델도 아니라고 직접 적었다. 부도 확률은 별도 모델이 맡고, 이력이 12개월이 안 되는 셀러는 트랜스포머 대신 보수적인 가벼운 모델로 보낸다.
부도 예측 모델에서 트리를 걷어낸 곳은 누뱅크 정도다. 그것도 트리 자리를 다른 신경망으로 바꾼 것이지, 트랜스포머 하나로 끝낸 것은 아니다. Affirm은 트리 앞단에 트랜스포머를 붙였고, Revolut은 비교 대상이 무엇인지 밝히지 않았다.
5. 2.3배라는 숫자
NVIDIA는 Revolut 사례를 소개하면서 PRAGMA가 신용 부도 위험을 2.3배 더 정확하게 잡는다고 썼다. 논문의 표를 보면 이건 PR-AUC가 130.2% 올랐다는 뜻이고, 같은 모델의 ROC-AUC는 12.4% 올랐다.
두 숫자 모두 논문에 있는 값이지만, PR-AUC는 부도율에 따라 출발점이 달라진다. 아무렇게나 찍는 모델의 PR-AUC가 부도율과 같기 때문이다. 부도율이 2%인 상품이라면 0.02에서 시작하고, 기존 모델이 0.10이었다면 2.3배는 0.23이다. 같은 개선이 ROC-AUC로는 훨씬 작게 보인다.
여기서 기존 모델이 0.10이라는 건 설명을 위한 가정이다. Revolut은 절대 수치가 사업상 민감하다며 상대 변화만 공개했다. 비교한 “과제별 기준 모델”이 어떤 종류인지도 논문에 없다. 그러니 “트리 모델보다 2.3배”라고 옮기면 틀린다.
Affirm의 숫자도 AUC의 상대 변화다. 운영 모델의 AUC가 얼마인지는 밝히지 않았고, 추가 승인 대출의 연체율이나 손실도 숫자로는 없다.
Falcon TST 2.0은 시계열 예측 벤치마크 GIFT-Eval에서 1위를 했다고 발표했는데, 이 1위에도 조건이 붙는다. 논문 기준으로 점 예측 오차(MASE)는 29개 모델 중 가장 좋았지만, 확률 예측 지표(CRPS)로는 7위다. 공개된 결과 파일로 다시 계산하면 MASE에서도 구글 TimesFM-3과의 차이가 0.001이 안 된다. 은행들이 “정확도 93% 이상”을 얻었다는 문구도 있는데, 정확도를 어떻게 쟀는지는 나와 있지 않다.
발표들에는 공통점이 있다. 모두 자기 회사의 이전 모델과 비교했고, 금융에서 가장 궁금한 숫자인 손실률은 아무도 공개하지 않았다.
6. 트리 모델이 남는 자리
발표를 꼼꼼히 읽으면 트리 모델이 쉽게 밀려나지 않을 근거도 같이 나온다.
성능부터 보면, Affirm의 트랜스포머 단독 모델은 최고 XGBoost를 넘지 못했다. Affirm은 다른 글에서 TabPFN 같은 사전학습 정형 모델들도 내부 데이터로 시험해 봤다. 전체적으로는 부스팅 트리와 그 앙상블이 가장 강했다고 했다. Visa도 LTM 소개 자료에서 GBT가 배포가 빠르고, 해석이 쉽고, 데이터가 적을 때 잘한다고 적었다. 트랜스포머가 앞서는 건 시퀀스를 읽는 부분이고, 이미 정리된 표 데이터는 여전히 트리가 잘 다룬다.
지연시간도 제약이다. Affirm은 입력 준비부터 점수까지 1초 안에 끝내야 했다. 그래서 트랜스포머를 붙이면서 서빙 경로를 CPU와 GPU 양쪽에서 따로 최적화했다. Parafin은 실시간이 아니라 하루 한 번 배치로 돌린다. A10 GPU 한 장으로 하루 수억 건의 예측을 1시간 안에 끝낸다고 적었다.
금융에서 특히 무거운 건 설명 의무다. 미국 Reg B는 대출을 거절할 때 구체적인 주된 사유를 알리라고 한다. “신용평가 점수가 기준에 못 미쳤다” 정도로는 부족하다고 규정한다. CFPB는 2022년에 복잡한 알고리즘을 쓴다고 해서 예외가 되지 않는다는 해석까지 냈다. 이 해석은 2025년 5월에 철회됐지만 Reg B 조항 자체는 그대로다. Affirm은 하이브리드 모델의 판단을 기존과 같은 수준으로 설명하는 자체 알고리즘을 따로 만들었다고 했다. 방법은 공개하지 않았다. 집계 피처라면 “최근 연체 횟수가 많음” 같은 사유가 바로 나오지만, 임베딩의 한 차원으로는 그런 문장을 만들기 어렵다.
고객 사이의 연결이 중요한 과제도 있다. Revolut은 자금세탁 탐지에서 PRAGMA(10억 파라미터, 선형 프로브)가 운영 모델보다 F0.5 기준 47.1% 나빴다고 밝혔다. 운영 모델은 여러 고객 사이의 네트워크 피처를 쓰는데, PRAGMA는 고객 한 명의 이력만 따로 읽기 때문이다.
라벨 문제도 남는다. 상환 결과는 승인된 대출에만 생기기 때문에, 과거 정책이 거절한 사람의 결과는 알 수 없다. Affirm도 이 점을 짚었다. 표현을 아무리 잘 배워도 이 선택 편향은 그대로 남는다.
7. 개인적인 견해
이번 발표들에서 가장 눈여겨본 숫자는 Affirm의 얇은 이력 고객 결과(2.1배)다. 집계 피처는 이력이 길 때 힘을 쓴다. 계좌가 한두 개뿐이면 “최근 6개월 연체 횟수” 같은 피처는 0인 경우가 많아서 모델이 쓸 정보가 적다. 계좌 하나하나의 이력을 직접 읽으면 짧은 이력에서도 쓸 수 있는 신호가 조금 더 나온다는 뜻으로 읽힌다.
국내에도 같은 숙제가 있다. 사회초년생이나 오랫동안 대출과 카드를 쓰지 않은 사람은 신용정보가 얇다. 국내 신용정보도 대출과 카드가 계좌 단위로 기록되니, 같은 접근을 시험해 볼 여지가 있다.
국내에서 시도한다면 Affirm 방식이 현실적인 출발점이라고 본다. 이미 검증받은 GBDT와 거절 사유 체계는 그대로 두고, 트랜스포머 임베딩을 피처 몇 개로 더하는 방식이다. 모델 검증 부서와 감독 당국에 설명해야 할 범위가 상대적으로 좁고, 효과는 이력이 얇은 고객 구간에서 따로 재면 된다. 근거도 쌓여 있다. 누뱅크에서도 임베딩을 LightGBM에 넣는 것만으로 개선의 대부분이 나왔다. 2022년 Sber AI Lab의 CoLES 논문에서도 거래 시퀀스 임베딩만 쓴 모델(AUROC 0.87)은 사람이 만든 피처(0.88)와 비슷했다. 둘을 합쳤을 때가 0.92로 가장 좋았다. Revolut처럼 수십억 건으로 기반 모델을 사전학습하는 건 데이터와 과제가 그만큼 많을 때 의미가 있다.
가장 어려운 부분은 설명이다. 국내 규정도 이 부분을 요구한다. 신용정보법 제36조의2는 자동화평가를 받은 사람이 평가 결과와 주요 기준을 설명해 달라고 요구할 수 있게 했다. 금융위원회가 올해 6월 개정한 금융분야 AI 가이드라인도 신용 관련 결정은 영향을 미친 주요 요인 위주로 안내하라고 적었다. 임베딩이 피처로 들어가면 “이 사람은 왜 거절됐나”에 답하기가 한 단계 더 어려워진다. Affirm이 방법을 공개하지 않은 바로 그 부분이 국내 금융회사들이 가장 먼저 부딪힐 문제라고 본다.
이런 발표를 볼 때는 비교 대상이 어떤 모델인지, 절대 수치는 얼마인지, PR-AUC라면 부도율은 몇 %인지, 승인을 늘린 뒤 손실은 어떻게 됐는지를 같이 확인해야 한다. Revolut의 2.3배도 이렇게 따져 보면 ROC-AUC 기준으로는 12.4% 개선이다.
함께 보면 좋은 글:
참고 자료
- Learning Richer Credit Representations with Transformers at Affirm (Affirm Tech Blog, 2026-09-17)
- Affirm launches transformer-based machine learning model for real-time underwriting (Affirm, 2026-09-17)
- The Model Is Not the Modeling (Affirm Tech Blog, 2026-09-29)
- PRAGMA: Revolut Foundation Model (Ostroukhov et al., arXiv:2604.08649, 2026)
- Revolut case study (NVIDIA)
- Revolut announces launch of dedicated AI research division, Revolut Research (Zawya, 2026-08-25)
- ParaFormer: A transformer architecture for small business credit underwriting (Parafin, 2026-05-19)
- ParaFormer in production (Parafin, 2026-06-12)
- Parafin is joining Stripe (Parafin, 2026-09-30)
- Falcon-TST (Ant International, GitHub)
- Falcon-2.0 (arXiv:2608.13262, 2026)
- Ant International’s FalconTST Model 2.0 achieves SOTA (Financial IT, 2026-08)
- GIFT-Eval results (Salesforce AI Research, GitHub)
- Bootstrapping your behavior: a new pretraining strategy for user behavior sequence data (arXiv:2506.11053, 2025)
- Your Spending Needs Attention: Modeling Financial Habits with Transformers (Nubank, arXiv:2507.23267 v2, 2026)
- Nubank’s AI-powered credit model extends access while maintaining portfolio quality (Nubank, 2026-05-07)
- Using AI to optimize payments performance with the Payments Intelligence Suite (Stripe, 2025-05-15)
- Large transaction models (LTMs) (Visa)
- Why do tree-based models still outperform deep learning on typical tabular data? (Grinsztajn et al., NeurIPS 2022)
- TabArena (Erickson et al., NeurIPS 2025)
- CoLES: Contrastive Learning for Event Sequences with Self-Supervision (Babaev et al., SIGMOD 2022)
- 12 CFR 1002.9 Notifications (Regulation B, CFPB)
- CFPB Circular 2022-03: Adverse action notification requirements in connection with credit decisions based on complex algorithms (CFPB)
- Withdrawal of CFPB guidance documents (Federal Register, 2025-05-12)
- 금융분야 AI 가이드라인 개정 (금융위원회, 2026-06-18)
본 글은 2026년 10월 22일 기준 각 회사의 기술 블로그, 논문, 보도자료를 바탕으로 작성했다. 성능 수치는 모두 회사가 발표한 상대 변화이며 절대값은 공개되지 않았다. PR-AUC 예시의 0.10은 설명을 위한 가정이다. 누뱅크 수치는 논문 개정판(2026년 8월) 기준이다. Falcon TST 2.0의 GIFT-Eval 순위는 공개된 결과 파일 기준이다. 그림은 각 출처의 원본이며, PRAGMA 그림은 CC BY 4.0 라이선스를 따른다.