2024년 유럽경제지역(EEA)에서 카드로 결제된 거래는 약 1,110억 건이었고, 그중 사기는 약 1,706만 건이었다.
건수로는 0.015%, 금액으로는 0.033%다. 유럽은행감독청(EBA)과 유럽중앙은행(ECB)이 2025년 12월에 낸 보고서의 숫자다. 사기 탐지 모델은 거래 만 건 가운데 한두 건을 골라내야 하고, 판단에 쓸 수 있는 시간은 결제 승인 전 100밀리초 안팎이다.
지난 트랜스포머 신용 모델 글에서는 거래 기록을 시퀀스로 읽는 모델이 신용평가에 들어오는 과정을 다뤘다. 사기 탐지에서도 같은 흐름이 있지만 사정이 조금 다르다. 사기는 연체보다 훨씬 드물고, 수법이 계속 바뀌고, 라벨이 늦게 온다. 그래서 거래 시퀀스 모델과 함께 라벨 없이 쓰는 이상 탐지, 사기 조직을 찾는 그래프 방법까지 같이 봐야 한다.
1. 사기 거래는 얼마나 드문가
같은 보고서에 따르면 2024년 EEA의 결제 사기는 모두 42억 유로였고, 그중 카드 사기가 13억 유로였다. 카드 사기 금액의 약 83%가 온라인 같은 비대면 결제에서 나왔는데, 비대면 결제가 전체 카드 결제 금액에서 차지하는 비중은 28% 정도에 그친다. 금액 기준 사기율도 비대면 결제가 0.091%로, 대면 결제(0.007%)보다 열 배 이상 높다.
라벨이 늦게 온다는 점도 중요하다. Worldline 연구진은 AISTATS 2022 논문에서 이를 실제 운영 데이터로 쟀다. 첫 사기 거래 후 1시간 안에 막힌 사기 카드는 약 1%였고, 하루 안에 막힌 카드도 30%가 안 됐다. 대부분은 일주일에서 열흘 사이에 막혔다. 고객이 이의를 제기하고 확인이 끝나야 그 거래에 “사기”라는 라벨이 붙기 때문이다.
Dal Pozzolo 등의 2018년 IEEE TNNLS 논문은 사기 탐지를 어렵게 만드는 요인으로 수법 변화에 따른 분포 이동(concept drift), 극단적인 클래스 불균형, 늦은 라벨 확인을 꼽았다. 조사 인력이 하루에 볼 수 있는 경보가 몇 건뿐이니 AUC보다 상위 경보의 정밀도를 보라는 게 이 논문의 권고다.
이런 조건 때문에 카드 업계는 사기 탐지 성능을 “정상 건을 몇 개 잘못 잡을 때 사기 금액을 얼마나 잡았나”로 잰다. 정상 5건을 잘못 잡을 때 사기 1건을 잡는 기준점을 5:1이라고 부르는데, 이때 ‘건’을 계정으로 셀지 거래로 셀지는 회사와 지표마다 다르다. FICO는 계정 단위의 AFPR(account false positive ratio)을 쓰고, Visa의 LTM 자료는 단위를 따로 밝히지 않았다. 이 기준점에서 잡아낸 사기 금액의 비율을 VDR(value detection rate)이라고 한다.
2. 거래 시퀀스를 읽는 사기 탐지 모델
가장 자세히 공개된 사례는 WeChat Pay의 PANTHER다. NeurIPS 2025 논문에 따르면 사용자 3,800만 명의 6개월치 거래 53억 건으로 트랜스포머를 사전학습했다. 학습 과제는 다음 거래 맞히기이고, 거래 한 건은 가맹점 업종과 금액 구간 같은 속성을 묶은 토큰 하나가 된다.
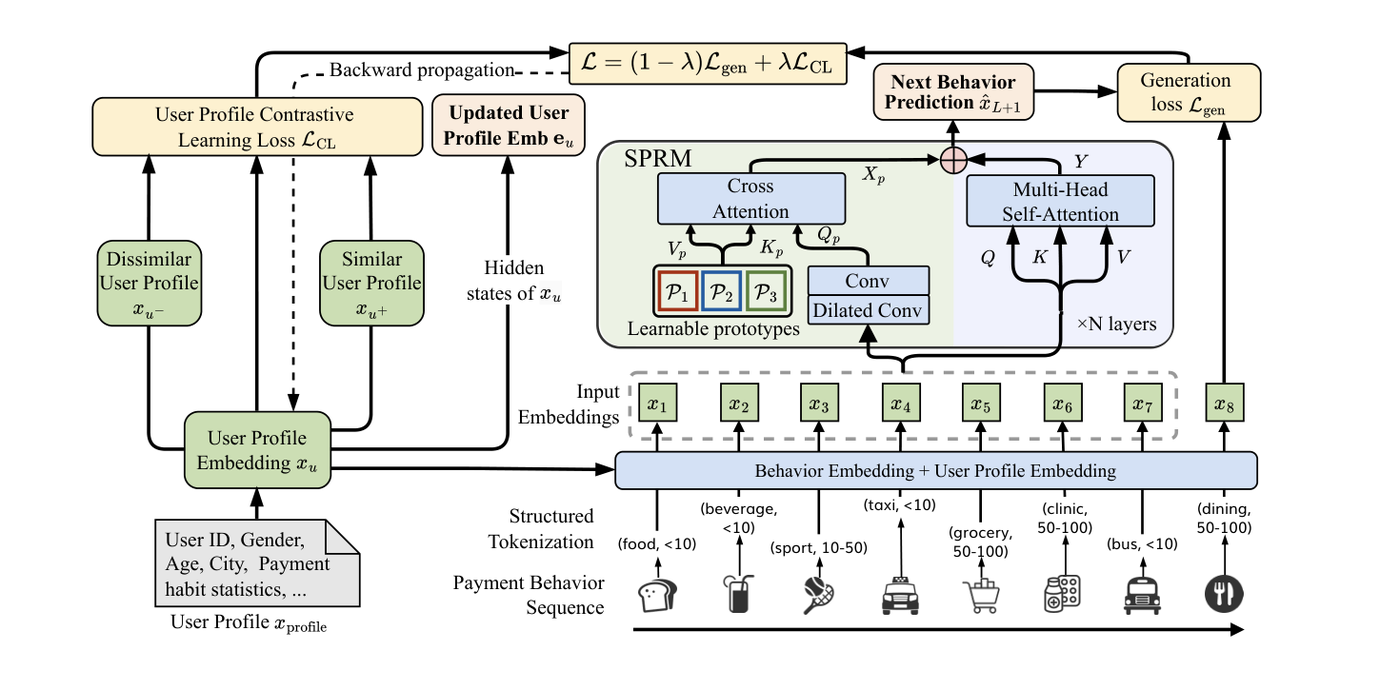
결제 행동 시퀀스를 (업종, 금액 구간) 토큰으로 바꿔 다음 행동을 예측하고, 사용자 프로필 임베딩을 대조 학습으로 함께 만든다. (출처: PANTHER, arXiv:2510.10102, CC BY 4.0)
운영에 붙이는 방식은 지난 글의 Affirm과 비슷하다. 사전학습한 모델에서 사용자 임베딩과 이탈 점수를 미리 뽑아 두는데, 이탈 점수는 지금 거래가 그 사용자의 평소 행동과 얼마나 다른지를 나타낸다. 실시간 판단은 이 두 값과 최근 거래 패턴, 거래 정보를 함께 받는 판별 모델(보통 DCN)이 맡는다. A/B 테스트의 비교 대상은 사람이 만든 피처와 TextCNN 시퀀스 인코더로 돌던 기존 DeepFM 모델이었다.
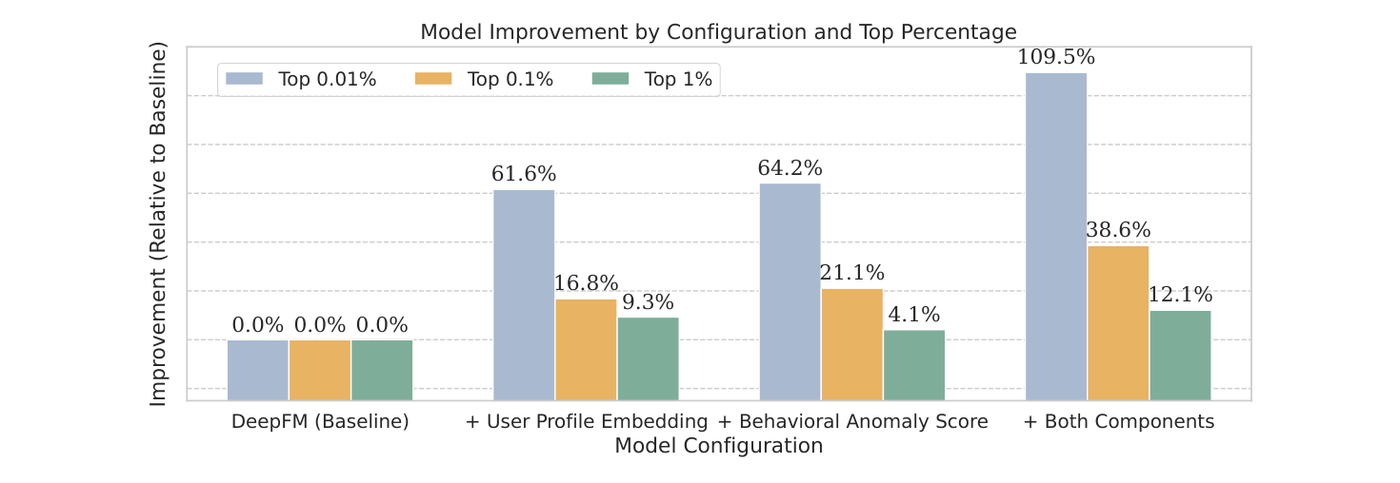
DeepFM 대비 사기 재현율의 상대 개선. 위험 점수 상위 0.01%, 0.1%, 1% 구간에서 잰 값이다. (출처: PANTHER, arXiv:2510.10102, CC BY 4.0)
WeChat Pay는 운영 시스템에서 10일 동안 전체 트래픽으로 A/B 테스트를 했다. 사기 재현율은 위험 점수 상위 0.01% 구간에서 109.5%, 상위 0.1%에서 38.6%, 상위 1%에서 12.1% 올랐다. 임베딩과 이탈 점수를 하나씩 넣을 때보다 함께 넣을 때 효과가 가장 컸다. 지연시간은 기준 모델보다 5ms 늘었지만 100ms 안쪽의 예산은 지켰다. 표현이 복잡해서 해석이 어렵다는 점은 논문 스스로 한계로 남겼다.
Stripe도 2025년에 수백억 건의 거래로 학습한 결제 파운데이션 모델을 공개했다. 거래 하나하나를 임베딩으로 압축하고, 그 임베딩의 시퀀스를 분류해 카드 테스팅 공격을 잡는다. 카드 테스팅은 훔친 카드 정보가 유효한지 소액 결제로 확인해 보는 공격이다. 대형 가맹점을 노린 공격의 탐지율은 59%에서 97%로 올랐는데, 정교한 공격 일부만 놓고 잰 숫자다.
Visa는 Featurespace를 인수한 뒤 거래 데이터용 대형 모델(LTM)을 내놓았다. 북미 비대면 거래로 한 개념 검증에서는 같은 5:1 기준점에서 운영 중인 GBT 모델보다 사기 금액을 5배 넘게 잡았다. 다만 이 결과에는 예시용이라는 각주가 붙어 있다. Revolut의 PRAGMA는 과제별 기준 모델보다 사기 재현율이 64.7%, 정밀도가 16.7% 높았다.
사기 탐지 회사 Sardine은 2026년 9월에 카드 발급사용 모델을 만든 과정을 꽤 솔직하게 공개했다. 사기 라벨 없이 다음 거래를 맞히도록 트랜스포머를 사전학습하고, 여기서 나온 임베딩과 의외성 점수(surprise score)를 피처 77개짜리 기존 XGBoost에 입력으로 더했다. 같은 비율로 경보를 낼 때 잡은 사기가 24~35% 늘었다. 처음 만든 버전은 오히려 성능이 나빴고, 기존 모델을 신경망으로 갈아 끼우지도 않았다.
Mastercard도 2026년 3월에 수십억 건의 거래로 학습한 대형 테이블 모델을 공개하면서, 기존 AI 모델과 새 모델을 합친 하이브리드 시스템을 만들 계획을 내놓았다. 성능 숫자는 없었다.
운영 방식까지 공개한 PANTHER와 Sardine은 기존 모델을 걷어내지 않았고, Mastercard도 하이브리드를 계획하고 있다. 파운데이션 모델이 만든 임베딩이나 이탈 점수를 기존 트리 모델이나 딥러닝 모델에 피처로 더하는 식이다.
3. 트리 모델을 아직 못 버리는 이유
반대쪽 근거도 꽤 탄탄하다.
Cash App과 Square를 운영하는 Block은 2026년 8월에 BlockTabBench 결과를 공개했다. 스캠, 계정 탈취 같은 사내 리스크 데이터셋 100개 이상을 시간 순서대로 나눠 PR-AUC를 비교한 실험이다. 데이터셋별로 1위를 세어 보면 XGBoost가 41%였고, 테이블 데이터용 딥러닝 모델인 TabM이 37%, 테이블 파운데이션 모델(TabFM)이 22%였다. 파운데이션 모델이 이긴 곳은 주로 라벨이 적은 데이터셋이었다. Block의 결론은 XGBoost가 상한에 가까운 성능을 낸다면 합리적인 기본값이라는 것이다. 다만 이 비교는 가공하지 않은 거래 시퀀스가 아니라 이미 만들어 둔 정형 피처를 입력으로 썼다.
Adyen은 2024년에 자사 사기 탐지가 트리 기반 앙상블 모델로 돌아간다고 밝혔다. 데이터가 대부분 정형 데이터라서 피처 수백 개를 넣은 부스팅만으로도 기본 성능이 좋다는 설명이다. 운영 부담과 안정성, 지연시간까지 따지면 딥러닝이 ROI를 높인다는 증거는 아직 보지 못했다고 한다. 평균 지연시간은 20ms, p99는 100ms다.
Visa도 LTM 소개 자료에서 GBT의 장점으로 빠른 배포, 쉬운 해석, 적은 데이터에서의 좋은 성능을 꼽았다. Sardine은 설명 가능성이 결정적인 걸림돌이 될 수 있고, 카드 발급 업무 밖에서는 파운데이션 모델의 이점이 줄거나 사라질 수 있다고 봤다. PANTHER가 실제 서비스에서 기존 모델 위에 얹는 방식을 택한 것도 같은 이유로 보인다. 지연시간과 설명 의무를 지키면서 시퀀스에서 나오는 신호만 더하는 쪽이 운영하기 쉽다.
4. 라벨 없이 찾는 이상 탐지
지금까지의 모델은 모두 과거에 확인된 사기 라벨로 학습한다. 처음 보는 수법이 나오면 라벨이 쌓일 때까지 시간이 걸리고, 그 사이 피해가 생긴다. 라벨 없이 “평소와 다른 것”을 찾는 이상 탐지가 필요한 이유다.
현업에서 많이 쓰는 방법은 2008년 ICDM에 실린 Isolation Forest다. 정상 데이터를 모델링하는 대신 데이터를 무작위로 계속 나눠서 이상치를 고립시킨다. 이상치는 수가 적고 값이 동떨어져 있어서 나무의 뿌리 가까이에서 빨리 고립되므로, 평균 경로 길이가 짧을수록 이상 점수가 높다. 신경망 쪽에서는 데이터를 복원하도록 학습시킨 뒤 복원 오차가 큰 거래를 이상으로 보는 방법이 오래 쓰였다. 오토인코더와 같은 구조의 복원 신경망(replicator neural network)으로 이상치를 찾은 2002년 Hawkins 등의 논문도 대표적인 응용으로 사기 탐지를 들었다.
2022년 NeurIPS에 실린 ADBench는 알고리즘 30개를 데이터셋 57개에서 비교했는데, 통계적으로 확실히 앞서는 비지도 방법은 없었다. 이상치 유형에 따라 이기는 방법이 달랐다. 주변 데이터와 비교해 튀는 국소 이상치에서는 LOF가, 전체 분포에서 동떨어진 전역 이상치에서는 kNN이 가장 좋았다.
라벨의 효과도 컸다. 실제 데이터셋에서는 이상치 라벨이 1%만 있어도 대부분의 준지도 방법이 가장 좋은 비지도 방법을 앞섰다. 다만 이상치를 유형별로 합성해 따로 비교하면, 라벨을 쓰는 방법이 확실히 이긴 건 이상치가 무리 지어 나타나는 유형뿐이었다. 나머지 유형에서는 이상치 유형을 미리 알고 맞는 방법을 고르는 편이 라벨 일부보다 나은 경우도 있었다. ADBench에는 사기 비율이 0.17%인 공개 카드 거래 데이터셋도 들어 있다.
5. 라벨 없이 모델을 고르는 문제
올해 8월 제주에서 열린 KDD 2026의 금융 머신러닝 워크숍(MLF 2026)에서 CMU Leman Akoglu 교수의 초청 강연을 들었다. 제목은 “Advancing Outlier Detection with Foundation Models”였고, 정형 데이터용 파운데이션 모델로 이상 탐지를 하는 연구를 다뤘다.
이 연구의 출발점은 모델 선택 문제다. 라벨이 없으면 어떤 탐지기를 어떤 하이퍼파라미터로 쓸지 고를 근거가 없다. 팀의 FoMo-0D 논문은 이를 이상 탐지의 핵심 병목으로 꼽는다. 이름의 0은 zero-shot, 즉 새 데이터셋에서 따로 학습하지 않는다는 뜻이다.
Akoglu 교수 팀은 이 문제를 오래 다뤄 왔다. 2023년 SIGKDD Explorations 리뷰에서는 과제 39개와 후보 모델 297개로 라벨 없이 모델을 고르는 내부 평가 방법들을 검증했는데, 실용적으로 쓸 만한 방법이 없었다. 단독 전략은 무작위 선택과 통계적으로 다르지 않았고, 여러 모델의 합의를 쓰는 전략도 기본 설정의 Isolation Forest보다 낫지 않았다. 2021년 NeurIPS의 MetaOD처럼 과거의 라벨 있는 벤치마크에서 메타학습해 고르는 방법도 나왔지만, 이것도 결국 다른 데이터의 라벨을 빌려 오는 방식이다.
강연에서 다룬 해법은 정형 데이터용 파운데이션 모델이다. 실제 데이터 없이 합성 데이터로만 사전학습하고, 새 데이터셋을 만나면 추가 학습이나 하이퍼파라미터 튜닝 없이 순전파 한 번으로 이상치를 판단한다. 팀의 첫 모델이 2025년 TMLR에 실린 FoMo-0D이고, 그다음이 ICML 2026에 실린 OutFormer다.
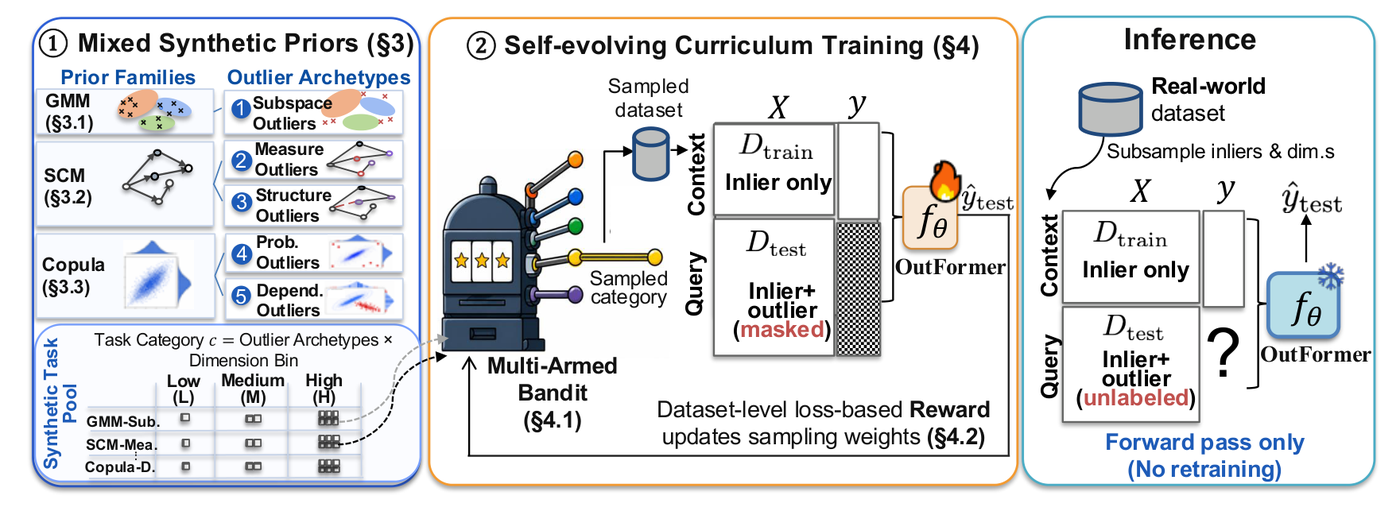
가우시안 혼합, 구조적 인과 모델, 코퓰라로 만든 합성 데이터와 여러 유형의 이상치로 사전학습한다. 학습 순서는 멀티암드 밴딧으로 조절하고, 실제 데이터에서는 학습 없이 순전파만 한다. (출처: OutFormer, arXiv:2602.03018, CC BY 4.0)
OutFormer는 파라미터 4,510만 개의 10층 트랜스포머로, 새 데이터셋의 학습 데이터를 문맥으로 넣으면 테스트 데이터의 각 행이 이상치인지 판단한다. 같은 팀의 MacrOData 논문은 KDD 2026 본 학회에 실렸다. ADBench의 데이터셋이 57개뿐이라는 한계를 보완하려고 벤치마크 세 개를 새로 만들었고, 데이터셋은 모두 합쳐 2,446개다.
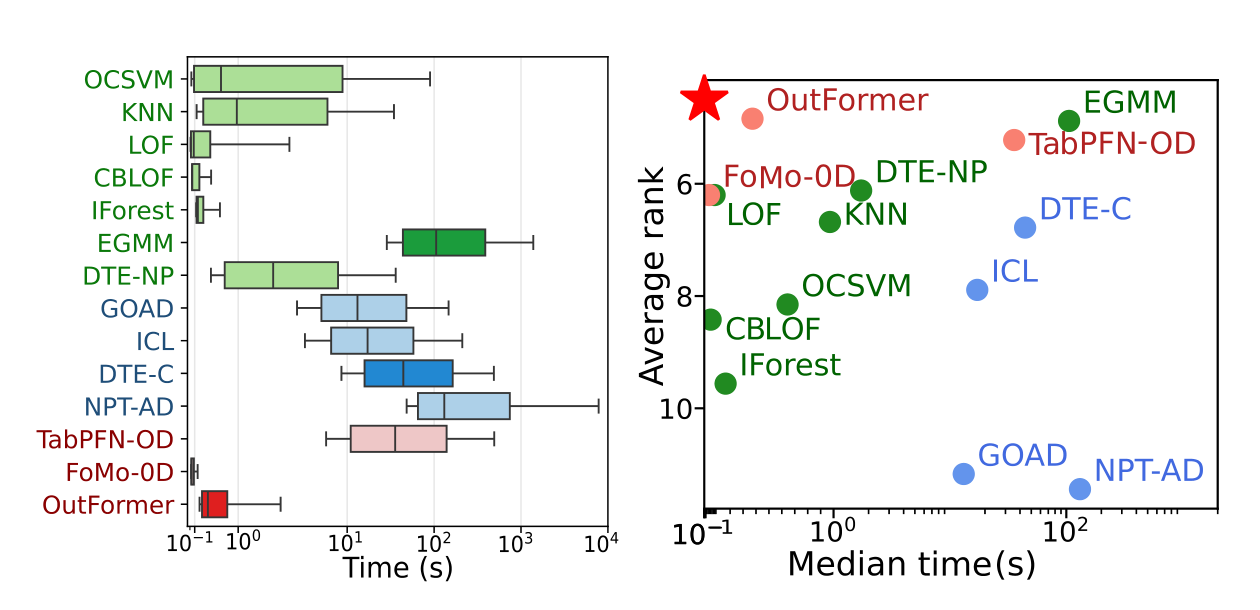
전체 데이터셋에서 방법별 실행 시간(왼쪽)과, 실행 시간 대비 평균 순위(오른쪽). 파운데이션 모델인 FoMo-0D와 OutFormer가 빠르면서 순위도 높다. (출처: MacrOData, arXiv:2602.09329, CC BY 4.0)
MacrOData의 2,446개 데이터셋에서 AUPRC 평균 순위가 가장 높은 건 OutFormer(4.84)였고, 고전 방법인 EGMM(4.88)이 거의 같은 순위로 뒤를 이었다. 그다음은 TabPFN 기반 탐지기(5.22), FoMo-0D(6.20), kNN(6.68) 순이었고 Isolation Forest는 9.56으로 한참 아래였다. 딥러닝 이상 탐지 방법들은 하이퍼파라미터에 민감해서 고전 방법보다 성적이 나빴다. 파운데이션 모델은 데이터셋마다 하이퍼파라미터를 고를 필요가 없어서 이 문제를 피한다.
숫자를 읽을 때 조심할 부분도 있다. OutFormer 논문에서 ADBench의 AUROC 평균 순위는 OutFormer가 4.02로 가장 높았지만, TabPFN 기반 탐지기(p=0.12)나 kNN(p=0.06)과의 차이는 통계적으로 유의하지 않았다. 새 벤치마크까지 포함한 전체 데이터셋의 AUPRC에서는 모든 비교 대상과의 차이가 유의했다. 그리고 이 벤치마크들에는 카드사나 결제사의 실제 거래 흐름이 들어 있지 않다. 실제 사기 데이터는 이상치 비율이 훨씬 낮고, 시간에 따라 분포도 바뀐다.
6. 사기 조직은 혼자 움직이지 않는다
지금까지의 방법은 거래 한 건이나 고객 한 명을 따로 본다. 그런데 계좌를 여러 개 굴리는 사기 조직이나 자금세탁은 고객 사이의 관계를 봐야 드러난다. Revolut의 PRAGMA는 자금세탁 탐지에서 운영 모델보다 F0.5 기준 47.1% 나빴다. 비교 대상은 고객 사이의 네트워크 정보를 쓰는 모델이었고, 저자들도 고객 한 명 단위의 표현만으로는 관계가 중요한 과제를 풀기에 부족할 수 있다고 짚었다.
그래프 쪽의 대표적인 방법은 CMU Christos Faloutsos 교수 팀이 KDD 2016에 발표한 FRAUDAR다. 사용자와 대상(상품, 계정 등)을 잇는 이분 그래프에서 사기 계정들이 촘촘한 덩어리를 만든다는 점에 착안한 방법이다. 사기 계정들은 들키지 않으려고 정상적이거나 인기 있는 대상에도 연결을 만드는데, FRAUDAR는 연결 수가 많은 대상의 가중치를 낮춰서 이런 위장 연결이 더해져도 사기 덩어리의 점수가 떨어지지 않게 했다. 2009년 트위터 그래프에서 이 방법으로 찾은 계정 덩어리는 대부분 팔로워 구매 서비스를 광고하고 있었다.
실무에서는 그래프 신경망을 그대로 운영에 넣기보다 그래프 신호를 피처로 바꿔 쓰는 경우가 많다. 알리페이의 GraphFAS(CIKM 2026)는 여러 단계 떨어진 이웃까지 본 그래프 피처를 해석 가능한 형태로 만들고, 그중 쓸 만한 것을 골라 트리 모델에 넣는다. 금융 리스크 관리에서는 그래프 신경망의 해석 가능성과 배포 부담이 걸림돌이었다는 게 이 연구의 문제의식이다.
7. 개인적인 견해
국내 FDS에 이 흐름을 가져온다면 순서가 중요하다고 본다.
첫 단계는 거래 시퀀스 모델의 임베딩과 이탈 점수를 기존 모델에 피처로 더하는 것이다. PANTHER와 Sardine이 이 방식을 택했고 Mastercard도 같은 방향을 밝혔다. 이렇게 하면 지연시간과 설명 의무를 지키면서 시퀀스 신호를 더할 수 있다. Block과 Adyen의 결과를 보면 잘 만든 정형 피처 위의 XGBoost를 이기기는 생각보다 어렵다. 새 모델을 붙일 때는 사기 비율이 실제처럼 낮은 데이터에서, 운영에서 쓰는 기준점(예를 들어 5:1)으로 잰 숫자를 봐야 한다.
새로운 수법을 잡으려면 이상 탐지가 필요한데, 이상 탐지에서는 모델 선택이 가장 어렵다. 라벨이 없으니 어떤 탐지기가 좋은지 확인할 방법이 없고, 기본 설정의 Isolation Forest도 의외로 이기기 어려운 기준이다. Akoglu 교수 팀의 파운데이션 모델은 이 선택 문제를 사전학습으로 미리 풀어 두려는 시도라서 실무에 의미가 크다. 다만 실제 결제 데이터에서 검증된 결과는 아직 없으니, 우리 데이터의 과거 사기 사례로 Isolation Forest, kNN과 나란히 비교해 보는 것이 먼저다.
라벨 지연도 따로 다뤄야 한다. 하루 안에 막히는 사기 카드가 30%도 안 된다면, 최근 며칠의 거래는 사기 라벨이 아직 붙지 않은 상태다. 이 기간의 데이터를 정상으로 보고 학습하면 최신 수법을 정상으로 배우게 된다. 학습 데이터의 마지막 며칠을 어떻게 다룰지는 모델 구조와 별개로 정해야 한다.
사기 조직과 자금세탁은 개인 단위 모델로는 잘 잡히지 않는다. 시퀀스 모델과 이상 탐지를 더해도 고객 사이의 관계를 보는 그래프 피처는 따로 챙겨야 한다. Revolut이 자금세탁 탐지에서 나빴던 결과까지 공개한 덕분에 개인 단위 파운데이션 모델의 한계를 확인할 수 있다.
함께 보면 좋은 글:
참고 자료
- 2025 Report on Payment Fraud (EBA·ECB, 2025-12)
- The Importance of Future Information in Credit Card Fraud Detection (Nguyen et al., AISTATS 2022)
- Credit Card Fraud Detection: A Realistic Modeling and a Novel Learning Strategy (Dal Pozzolo et al., IEEE TNNLS 2018)
- Value Detection Rate: A Performance Metric for Payments Fraud Detection (J.P. Morgan AI Research, ICAPS 2023 FinPlan)
- PANTHER: Generative Pretraining Beyond Language for Sequential User Behavior Modeling (WeChat Pay, NeurIPS 2025)
- Using AI to optimize payments performance with the Payments Intelligence Suite (Stripe, 2025-05-15)
- Card testing (Stripe Docs)
- Large transaction models (LTMs) (Visa)
- PRAGMA: Revolut Foundation Model (arXiv:2604.08649, 2026)
- Foundation models for issuer fraud detection (Sardine, 2026-09-10)
- Mastercard’s new generative AI model (Mastercard, 2026-03-17)
- BlockTabBench: Evaluating tabular models across Block’s machine learning ecosystem (Block, 2026-08-25)
- How Adyen does AI (Adyen, 2024-08-16)
- Isolation Forest (Liu, Ting, Zhou, ICDM 2008)
- Outlier Detection Using Replicator Neural Networks (Hawkins et al., DaWaK 2002)
- ADBench: Anomaly Detection Benchmark (Han et al., NeurIPS 2022)
- KDD 2026 Workshop on Machine Learning in Finance (MLF 2026) speakers
- The Need for Unsupervised Outlier Model Selection (Ma, Zhao, Zhang, Akoglu, SIGKDD Explorations 2023)
- Automatic Unsupervised Outlier Model Selection, MetaOD (Zhao, Rossi, Akoglu, NeurIPS 2021)
- FoMo-0D: A Foundation Model for Zero-shot Tabular Outlier Detection (Shen, Wen, Akoglu, TMLR 2025)
- From Zero to Hero: Advancing Zero-Shot Foundation Models for Tabular Outlier Detection, OutFormer (ICML 2026)
- MacrOData: New Benchmarks of Thousands of Datasets for Tabular Outlier Detection (KDD 2026)
- FRAUDAR: Bounding Graph Fraud in the Face of Camouflage (Hooi et al., KDD 2016)
- GraphFAS (Alipay, CIKM 2026)
본 글은 2026년 10월 23일 기준 논문, 기업 기술 블로그, 보도자료를 바탕으로 작성했다. 성능 수치는 각 회사와 저자가 발표한 값이며, 대부분 자사 이전 모델과 비교한 상대 변화다. Visa의 수치는 자료에 예시용 결과라고 적혀 있다. MacrOData 데이터셋 수는 arXiv 최신판 기준이다. 논문 그림은 CC BY 4.0 라이선스를 따른다.