금융 AI에서 FDS는 ML과 DL을 어떻게 사용할까?
얼마 전 금융 AI 에이전트 강의를 했을 때, 강의 후 질문을 가장 많이 받은 부분 중 하나가 FDS, 즉 Fraud Detection System이었다.
생각보다 많은 학생들이 “금융 AI에서 실제로 머신러닝은 어디에 쓰이나요?”, “사기 탐지는 그냥 룰로 막는 건가요?”, “딥러닝도 실무에서 정말 쓰이나요?” 같은 질문을 했다.
그런데 막상 FDS를 실무 관점에서 쉽게 설명하는 자료는 많지 않다. 신용평가, 투자, LLM 에이전트에 대한 글은 많지만, 결제 사기 탐지처럼 실제 금융 서비스의 손익과 고객 경험을 동시에 다루는 주제는 상대적으로 덜 알려져 있다.
그래서 이번 글에서는 조금 예전 자료이지만 여전히 좋은 참고 사례인 Stripe Radar를 중심으로, 글로벌 결제 인프라 기업 Stripe가 머신러닝을 어떻게 사기 탐지에 활용하는지 정리해보려 한다. Stripe의 해당 가이드는 2021년 12월에 업데이트된 자료이며, Radar가 Stripe 네트워크 데이터를 활용해 온라인 카드 결제 사기를 탐지하는 방식을 설명한다. (Stripe)
이번 글은 결제 사기 탐지 전체를 모두 다루기보다는, 온라인 결제 순간에 FDS가 어떤 방식으로 위험을 판단하는가에 초점을 둔다. 결제 수단별 사기 유형, 계정 탈취, 환불 악용, 프로모션 악용, 대포 계정 문제는 이후 시리즈에서 따로 다뤄볼 수 있다.
FDS는 단순한 “사기냐 아니냐” 분류 문제가 아니다
FDS를 처음 접하면 보통 이렇게 생각하기 쉽다.
거래 데이터를 넣고, 사기면 1, 정상이면 0으로 분류하는 모델 아닌가?
기술적으로는 맞다. 하지만 실무적으로는 너무 단순한 설명이다.
FDS의 진짜 어려움은 세 가지다.
첫째, 사기는 매우 희소하다. 대부분의 거래는 정상이고, 사기 거래는 극히 일부다. 모델은 거대한 정상 거래 속에서 아주 작은 이상 신호를 찾아야 한다.
둘째, 판단은 실시간이어야 한다. 결제가 들어온 뒤 몇 분 후에 “이거 사기 같아요”라고 말하면 이미 늦다. 사용자가 결제 버튼을 누른 직후, 승인·거절·추가 인증·수동 리뷰 중 하나를 거의 즉시 결정해야 한다.
셋째, 사기를 너무 잘 막아도 문제가 된다. 정상 고객을 잘못 막으면 매출이 사라지고 고객 경험이 나빠진다. Stripe도 false negative, 즉 사기를 놓치는 문제와 false positive, 즉 정상 고객을 잘못 차단하는 문제 사이의 trade-off가 핵심이라고 설명한다. (Stripe)
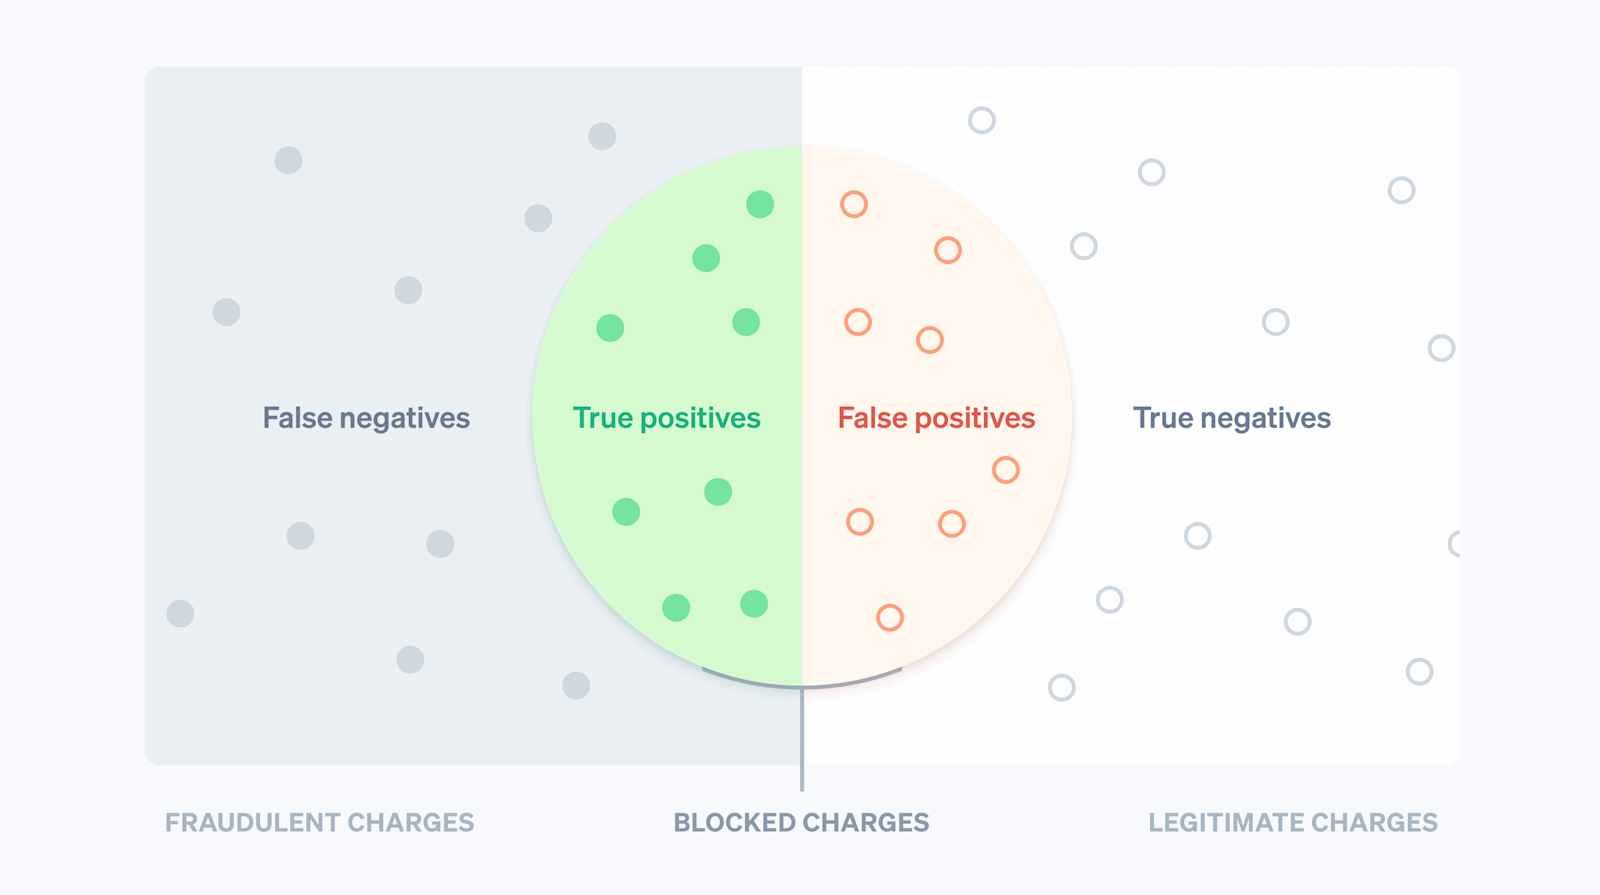
false negative와 false positive 사이의 trade-off. (출처: Stripe)
결국 FDS는 “모델 정확도”만의 문제가 아니다. 사기 손실, 승인율, 고객 마찰, 운영 비용, 리뷰 인력, 차지백 리스크를 동시에 최적화하는 의사결정 시스템에 가깝다.
Stripe Radar의 핵심 경쟁력은 모델보다 데이터다
Stripe Radar를 볼 때 가장 먼저 봐야 할 것은 모델 구조가 아니라 데이터 구조다.
Stripe는 수많은 비즈니스, 은행, 결제 네트워크와 연결되어 있다. Stripe 공식 자료에 따르면 Radar는 Stripe 네트워크 전체에서 자동으로 수집되는 결제 데이터를 활용하며, Stripe 네트워크에서 사용된 카드의 90%는 한 번 이상 다시 관측된 적이 있다. (Stripe)
이게 왜 중요할까?
한 쇼핑몰만 보면 어떤 카드가 처음 등장한 것처럼 보일 수 있다. 하지만 Stripe 전체 네트워크에서 보면 그 카드는 이미 다른 가맹점에서 여러 번 사용되었을 수 있다. 어떤 IP에서 여러 카드가 시도되었는지, 어떤 카드가 여러 국가에서 갑자기 사용되는지, 어떤 이메일·디바이스·카드 조합이 이상한지 같은 패턴도 네트워크 단위로 보면 훨씬 잘 보인다.
즉, Stripe의 강점은 단순히 “좋은 AI 모델”이 아니다. 여러 가맹점에서 발생하는 결제 행위를 하나의 네트워크 지식으로 바꾸는 능력이다.
이것은 금융 AI에서 매우 중요한 포인트다. 모델은 결국 데이터 위에서 작동한다. FDS에서는 특히 “내 서비스 안의 거래”만 보는 것과 “네트워크 전체의 행위 패턴”을 보는 것 사이에 큰 차이가 생긴다.
머신러닝은 룰보다 미묘한 패턴을 잡는다
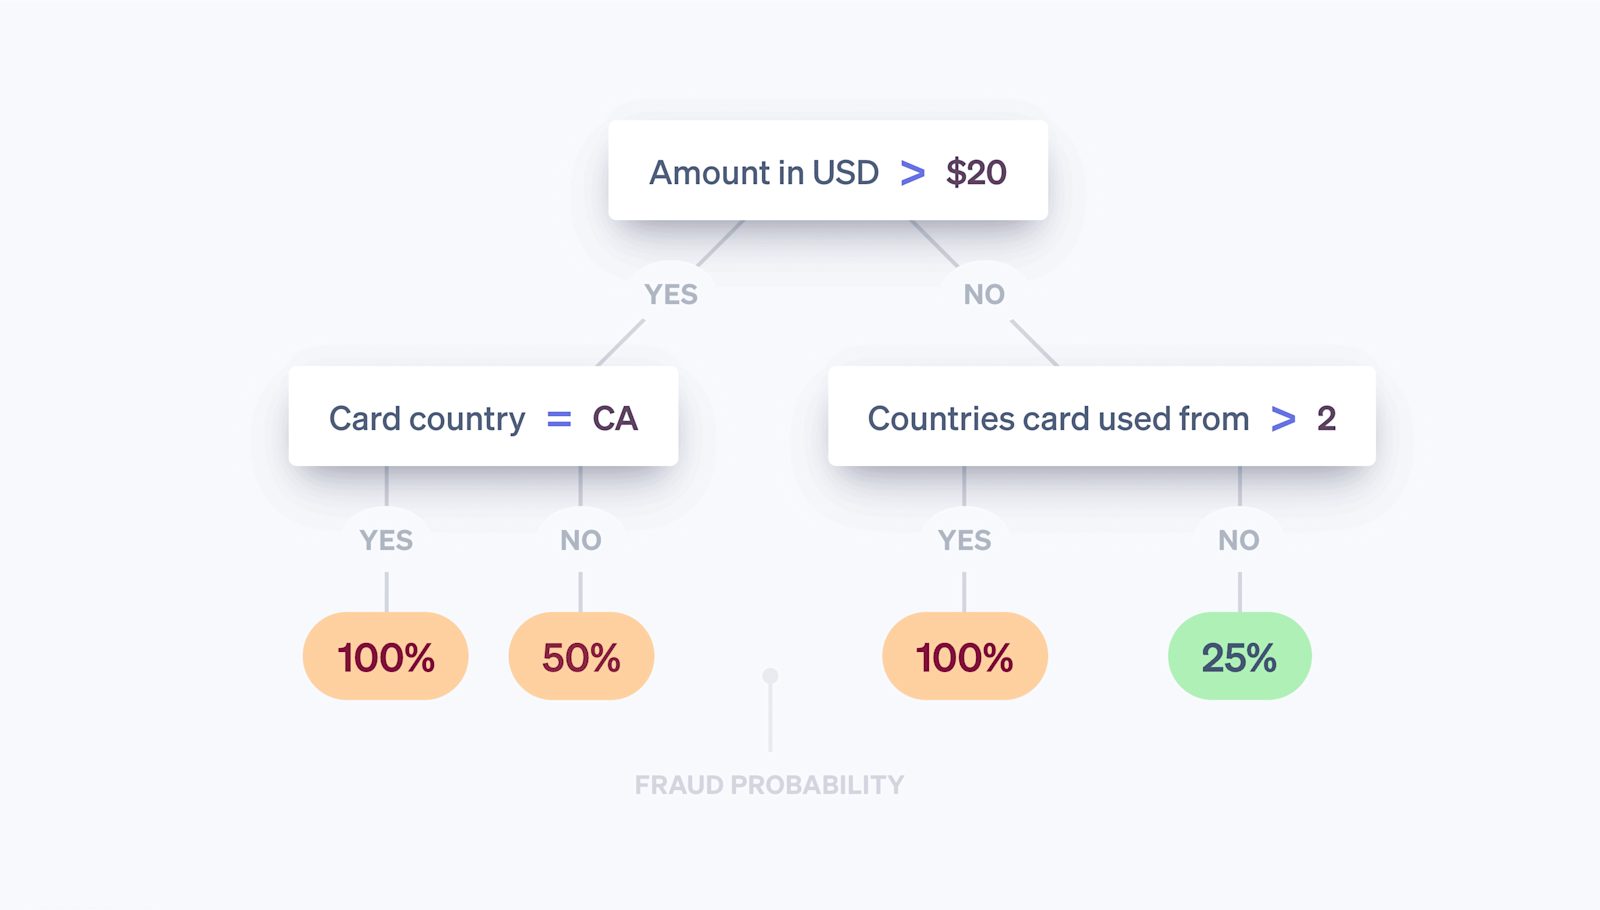
여러 feature로 분기해 사기 확률을 추정하는 모델 예시. (출처: Stripe)
전통적인 사기 탐지는 룰 기반으로 시작하는 경우가 많다. 예를 들어 이런 식이다.
- 해외 IP이면 차단
- 동일 카드로 짧은 시간 안에 여러 번 결제하면 차단
- 특정 국가 카드이면 리뷰
- 고액 결제이면 추가 인증
룰은 이해하기 쉽고 운영자가 직접 제어할 수 있다는 장점이 있다. 하지만 문제는 너무 거칠 수 있다는 점이다.
“해외 IP”라고 해서 모두 사기는 아니다. 여행 중인 정상 고객일 수도 있다. “고액 결제”라고 해서 모두 위험한 것도 아니다. 오히려 좋은 고객일 수도 있다.
Stripe도 하드코딩된 룰은 정상 거래까지 막을 수 있으며, 머신러닝은 여러 신호를 함께 고려해 더 미묘한 패턴을 잡을 수 있다고 설명한다. (Stripe)
여기서 중요한 개념이 feature다. FDS 모델은 단순히 결제 금액 하나만 보지 않는다. 예를 들어 다음과 같은 신호를 함께 본다.
- 같은 카드가 최근 몇 분 안에 몇 번 시도되었는가
- 같은 IP에서 서로 다른 카드가 몇 개나 사용되었는가
- 같은 디바이스가 여러 계정과 연결되어 있는가
- 특정 카드가 최근 24시간 동안 몇 개 국가에서 사용되었는가
- 카드 발급 국가와 접속 국가가 얼마나 다른가
- 특정 가맹점에서 승인 실패율이 갑자기 튀었는가
Stripe 공식 가이드도 Radar가 수백 개의 feature를 사용하며, 그중 상당수가 Stripe 네트워크 전체에서 계산된 aggregate feature라고 설명한다. (Stripe)
실무적으로 말하면 FDS의 성능은 모델 알고리즘만으로 결정되지 않는다. 좋은 피처를 얼마나 빨리 만들고, 실시간으로 안정적으로 계산하고, 운영 환경에 연결할 수 있느냐가 훨씬 중요하다.
딥러닝은 어디에 쓰일까? 핵심은 “표현 학습”이다
여기서 많은 사람들이 궁금해한다. “그럼 FDS에서도 딥러닝을 쓰나요?”
쓴다. 다만 “딥러닝을 쓰면 갑자기 사기를 다 잡는다”는 식으로 이해하면 안 된다.
FDS에서 딥러닝의 장점은 복잡한 비선형 관계를 학습하고, 카드·가맹점·은행·국가·디바이스 같은 범주형 정보를 더 풍부하게 표현할 수 있다는 데 있다. Stripe도 대규모 네트워크 데이터를 가지고 있기 때문에 neural network와 deep learning 같은 더 복잡한 접근을 활용할 수 있다고 설명한다. (Stripe)
이때 자주 등장하는 개념 중 하나가 embedding이다.
결제 데이터에는 범주형 변수가 매우 많다. 예를 들어 merchant ID, 발급 은행, 국가, 카드 BIN, 이메일 도메인, 디바이스, 요일, 결제수단 같은 값들이다. 이런 값들은 숫자처럼 단순히 크고 작음으로 비교하기 어렵다.
Embedding은 이런 범주형 값을 벡터 공간에 배치하는 방식이다. 비슷한 거래 패턴을 가진 가맹점, 국가, 은행, 결제 환경은 비슷한 위치에 놓이게 된다. Stripe도 merchant, issuing bank, user country, day of week 등 다양한 범주형 feature에 embedding을 사용한다고 설명한다. (Stripe)
다만 여기서 조심해야 한다. Embedding이 딥러닝의 전부는 아니다. 그리고 embedding 하나만으로 사기 탐지가 해결되는 것도 아니다. 더 정확히 말하면 embedding은 FDS에서 딥러닝이 활용될 수 있는 여러 방식 중 하나다.
예를 들어 어떤 가맹점과 다른 가맹점의 거래 패턴이 비슷하다면, 모델은 두 가맹점을 완전히 별개의 ID로만 보지 않고 유사한 맥락으로 이해할 수 있다. 특정 지역이나 특정 가맹점군에서 관측된 위험 패턴이 있을 때, 유사한 거래 구조를 가진 다른 영역에서도 더 잘 일반화할 가능성이 생긴다.
즉, 딥러닝의 역할은 “사기를 외워서 맞히는 것”이 아니라, 복잡한 결제 맥락을 더 나은 표현으로 바꾸고 그 표현을 바탕으로 위험도를 계산하는 것에 가깝다.
FDS에서 라벨은 생각보다 깨끗하지 않다
초보자들은 보통 이렇게 생각한다.
사기 거래에는 fraud label이 붙어 있고, 정상 거래에는 normal label이 붙어 있겠지.
하지만 실무 FDS의 라벨은 훨씬 지저분하다. 결제 사기 라벨은 보통 다음과 같은 경로로 들어온다.
- 카드 소유자의 dispute
- chargeback
- 환불 이력
- 수동 리뷰 결과
- 고객 신고
- 카드 네트워크 또는 발급사의 위험 신호
- 내부 조사 결과
문제는 이 라벨들이 늦게 들어오고, 불완전하고, 운영 정책의 영향을 받는다는 점이다.
특히 중요한 문제가 있다. 차단한 거래는 실제로 사기였는지 알기 어렵다. 이미 결제를 막았기 때문에, 그 거래가 그대로 진행되었다면 차지백이 발생했을지, 정상 고객이었을지 관측할 수 없다.
Stripe도 production 환경에서 precision-recall이나 ROC curve를 계산하는 일은 validation set에서 계산하는 것보다 훨씬 복잡하며, 차단된 결제에 대해 “무슨 일이 일어났을지”를 추정하는 counterfactual analysis가 필요하다고 설명한다. (Stripe)
이 부분이 FDS를 일반적인 분류 문제보다 어렵게 만든다. 모델을 만들 때는 사기 라벨이 필요하지만, 모델이 실제로 개입하는 순간 일부 라벨은 관측되지 않는다. 그래서 FDS 평가는 단순한 test set AUC보다 훨씬 복잡하다.
좋은 FDS는 모델 하나가 아니라 의사결정 레이어다
Stripe 사례에서 특히 중요한 부분은 모델 점수가 곧바로 최종 판단이 아니라는 점이다.
모델은 각 거래에 대해 위험 점수를 계산한다. 하지만 그 다음에는 비즈니스 상황에 따라 다른 액션을 취할 수 있다.
- 낮은 위험: 승인
- 높은 위험: 차단
- 애매한 위험: 추가 인증
- 더 애매한 경우: 수동 리뷰
- 특정 가맹점 조건: 커스텀 룰 적용
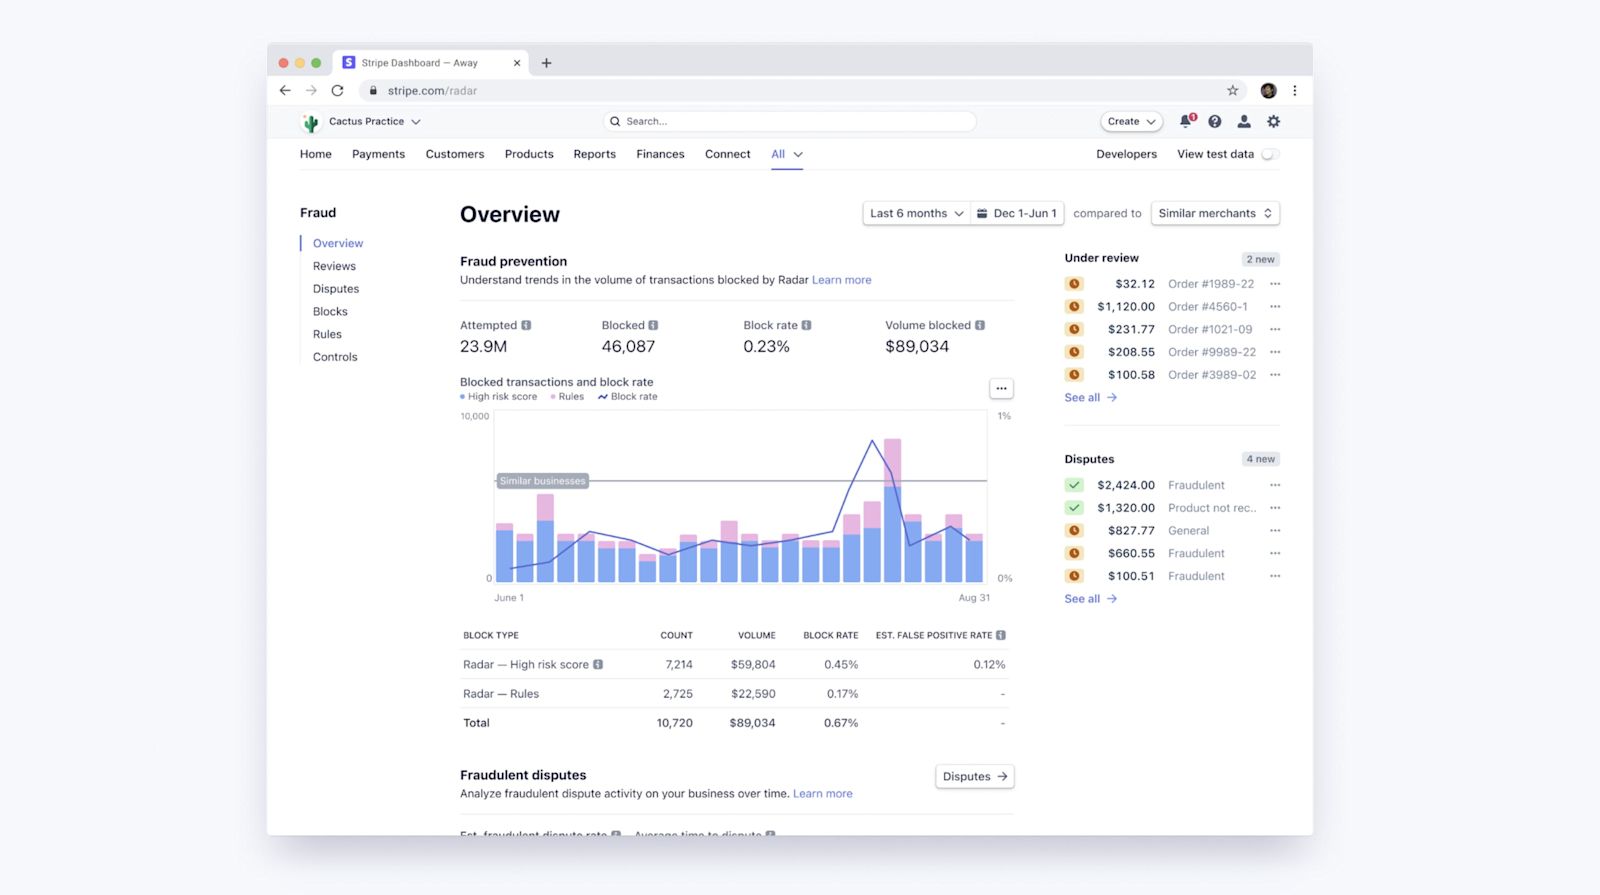
모델 점수 위에 룰·추가 인증·리뷰가 얹히는 Stripe Radar 화면. (출처: Stripe)
Stripe는 Radar에서 사용자가 위험 임계값을 조정하거나 커스텀 룰, 수동 리뷰를 활용할 수 있게 한다. Stripe 공식 가이드도 룰, intervention, manual review가 사용자의 precision-recall curve를 유리하게 바꾸는 도구가 될 수 있다고 설명한다. (Stripe)
이 부분이 실무에서 정말 중요하다. FDS 모델을 잘 만든다는 것은 AUC를 0.01 올리는 일만이 아니다. 어떤 거래를 바로 막고, 어떤 거래는 추가 인증으로 돌리고, 어떤 거래는 리뷰팀에 넘기고, 어떤 거래는 고객 경험을 위해 통과시킬지 결정하는 정책 설계가 함께 필요하다.
이것이 바로 FDS가 데이터 사이언스와 리스크 운영이 만나는 지점이다.
룰은 낡은 방식이 아니라 운영 제어 장치다
여기서 한 가지 오해를 피해야 한다. 룰 기반 시스템은 낡았고, 머신러닝은 최신 방식이라는 식으로 생각하면 안 된다. 실제 FDS에서는 룰이 여전히 중요하다. 룰은 보통 이런 역할을 한다.
- 명확한 known bad pattern 차단
- 신규 공격에 대한 긴급 대응
- 정책상 반드시 막아야 하는 조건 반영
- 특정 가맹점의 비즈니스 규칙 반영
- 리뷰 큐 라우팅
- allowlist 또는 blocklist 운영
- 모델이 아직 학습하지 못한 신규 패턴 보완
즉, 룰은 ML의 하위 호환이 아니다. 룰은 운영자가 시스템을 제어하는 장치에 가깝다.
좋은 FDS는 룰을 없애는 시스템이 아니라, 룰과 모델을 충돌 없이 함께 운영하는 시스템이다. 모델은 복잡한 위험도를 계산하고, 룰은 비즈니스 정책과 운영 판단을 반영한다.
FDS 평가는 AUC 하나로 끝나지 않는다
머신러닝을 배울 때는 AUC, accuracy, precision, recall 같은 지표를 많이 본다. 물론 FDS에서도 이런 지표는 중요하다. 하지만 실무에서는 조금 더 다르게 봐야 한다.
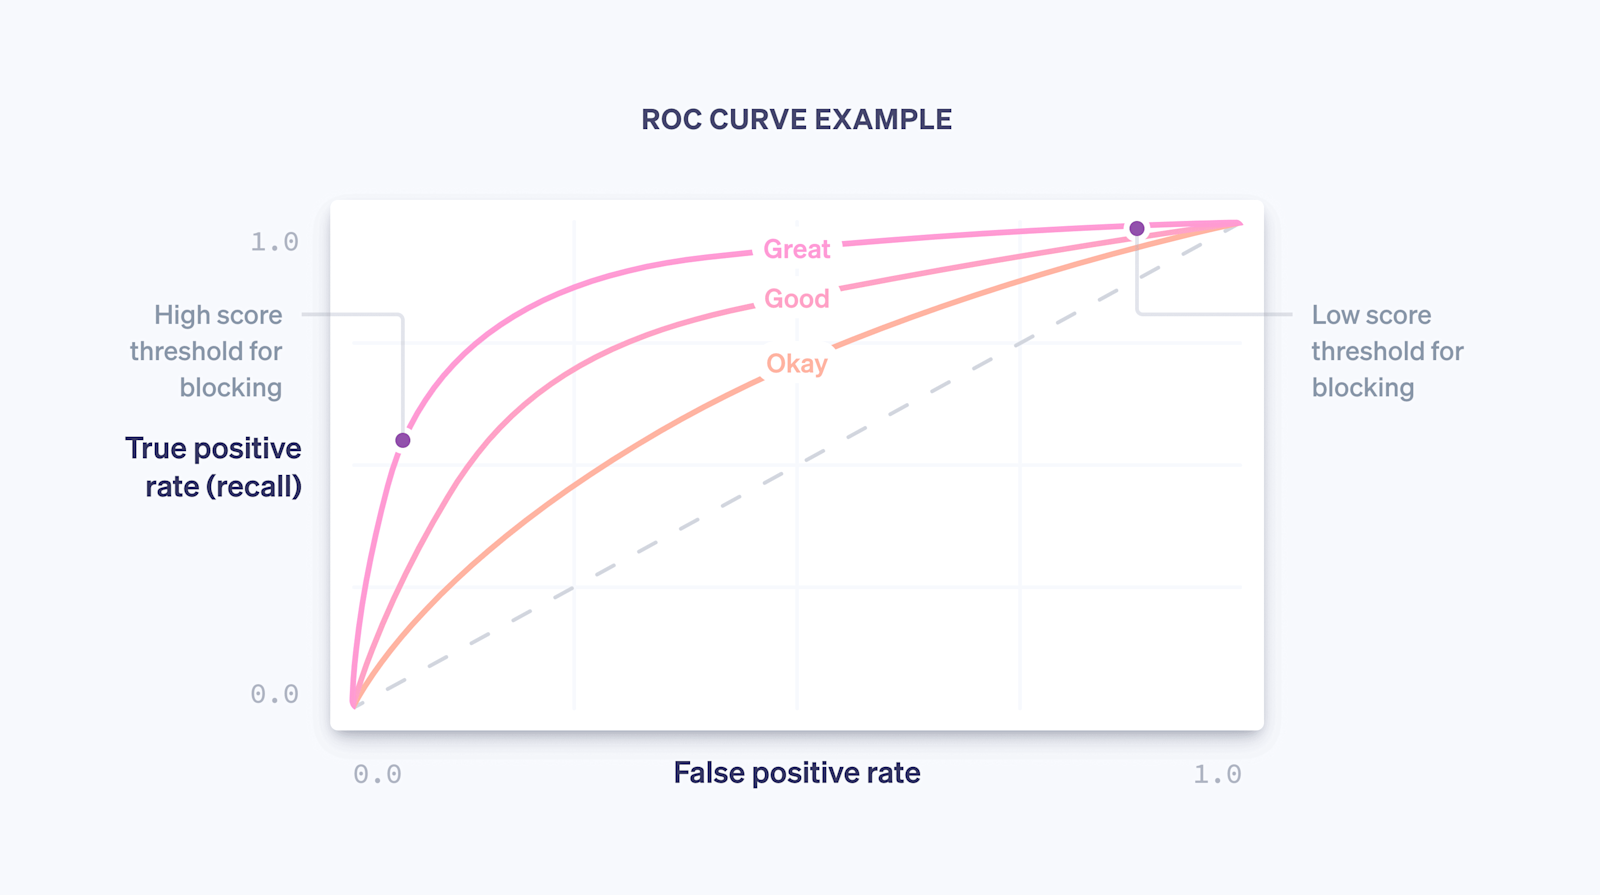
같은 false positive rate에서 더 많은 fraud를 잡을수록 좋은 모델이다. (출처: Stripe)
AUC가 좋아졌다고 바로 좋은 모델이라고 말하기 어렵다. 실제 운영에서는 다음 질문이 더 중요할 수 있다.
- 같은 false positive rate에서 fraud를 더 많이 잡는가
- 리뷰팀이 감당 가능한 물량 안에서 precision이 충분한가
- 차단율이 갑자기 올라가지는 않는가
- 승인율이 떨어지지는 않는가
- 특정 가맹점이나 특정 국가에서만 과도하게 막히지는 않는가
- chargeback rate는 줄었는가
- 고객 마찰은 얼마나 늘었는가
Stripe도 모델 평가에서 precision-recall curve, ROC curve, AUC를 함께 보고, 모델 변경 시 score distribution 변화도 모니터링한다고 설명한다. 특히 새 모델을 배포할 때 기존 merchant의 차단 정책과 충돌하지 않도록 threshold 이상에 걸리는 거래 비율을 안정적으로 유지하려고 한다. (Stripe)
이것이 실무 FDS의 핵심이다. 모델 성능은 단순히 “예측을 잘하느냐”가 아니라, 운영 정책 안에서 안정적으로 더 나은 의사결정을 만들 수 있느냐로 평가해야 한다.
배포와 운영이 모델만큼 중요하다
FDS는 연구실 모델과 다르다. 좋은 모델을 만들었다고 끝이 아니다. 실제 결제 API 흐름 안에서 낮은 지연시간으로 작동해야 한다. 학습 때 사용한 피처를 실시간으로도 계산할 수 있어야 한다. 새 모델이 전체적으로 좋아 보여도 특정 가맹점의 차단율을 갑자기 높이면 문제가 된다.
Stripe 공식 가이드는 production 배포에서 두 가지 과제를 강조한다. 하나는 모든 feature를 새 결제마다 실시간으로 계산해야 한다는 점이고, 다른 하나는 새 모델이 기존 운영 정책에 갑작스러운 충격을 주지 않도록 score distribution을 비교해야 한다는 점이다. (Stripe)
이것은 금융 AI에서 매우 중요한 교훈이다. 모델 성능이 좋아졌다는 말은 운영 관점에서 충분하지 않다. 다음 질문까지 답해야 한다.
- 승인율은 어떻게 바뀌는가
- 정상 고객 차단은 늘지 않는가
- 특정 가맹점이나 특정 세그먼트에 불리한 변화는 없는가
- 리뷰 물량은 감당 가능한가
- 차지백은 줄었는가
- 모델 점수 분포가 기존 정책과 충돌하지 않는가
좋은 FDS는 모델링 프로젝트가 아니라 지속적으로 배포·모니터링·재학습되는 운영 시스템이다.
금융 AI 관점에서 얻을 수 있는 교훈
Stripe Radar 사례를 금융 AI 관점에서 정리하면 네 가지 교훈이 있다.
첫째, FDS의 본질은 classification이 아니라 decisioning이다. 모델은 사기 확률을 예측하지만, 비즈니스는 그 점수를 바탕으로 승인·차단·인증·리뷰라는 액션을 결정해야 한다.
둘째, 데이터 네트워크 효과가 매우 중요하다. 개별 가맹점 데이터만으로는 보이지 않는 패턴이 네트워크 전체에서는 보인다. FDS에서 데이터 규모와 연결성은 모델 구조만큼 중요하다.
셋째, 딥러닝은 마법이 아니라 표현 학습의 도구다. Embedding 같은 방식은 수많은 범주형 결제 신호를 더 나은 형태로 표현하는 데 도움을 줄 수 있다. 하지만 이것은 전체 시스템의 일부일 뿐이다. FDS의 성능은 모델 구조, 피처, 라벨 품질, 실시간 인프라, 운영 정책이 함께 맞물릴 때 나온다.
넷째, 실무 FDS는 MLOps와 리스크 운영이 결합된 시스템이다. 모델을 자주 재학습하고, 점수 분포를 모니터링하고, 임계값을 조정하고, 룰과 리뷰를 함께 운영해야 한다.
마무리
FDS는 금융 AI를 배우는 사람에게 매우 좋은 주제다. 왜냐하면 여기에 머신러닝의 거의 모든 현실 문제가 들어 있기 때문이다.
희소한 라벨, 실시간 추론, 불균형 데이터, precision-recall trade-off, 고객 마찰, explainability, 모델 드리프트, 재학습, 룰 엔진, 수동 리뷰, 그리고 비즈니스 손익까지 모두 연결된다.
그래서 FDS를 이해하면 금융 AI가 단순히 “모델을 잘 만드는 일”이 아니라는 것을 알 수 있다. 좋은 금융 AI 시스템은 예측 모델, 데이터 인프라, 의사결정 정책, 운영 피드백 루프가 함께 설계되어야 한다.
Stripe Radar 사례가 흥미로운 이유도 여기에 있다. 100ms 안에 사기 거래를 판단한다는 말은 단순히 빠른 모델을 쓴다는 뜻이 아니다. 그 100ms 안에는 수많은 네트워크 데이터, 실시간 피처, ML/DL 모델, 룰, 임계값, 추가 인증, 리뷰 전략, 배포 안정성이 모두 압축되어 있다.
결국 FDS는 금융 AI의 가장 실전적인 얼굴 중 하나다.
출처: A primer on machine learning for fraud protection (Stripe)
함께 보면 좋은 글: 금융 AI에서의 에이전틱 엔지니어링